Die meisten Ratschläge zur Mensch-KI-Zusammenarbeit sind so geschrieben, als wäre die KI der schwierige Teil. Wähle das richtige Modell, schreibe einen brauchbaren Prompt, und der Rest ergibt sich von selbst. Dann probierst du es mit einem echten Team aus, und der schwierige Teil entpuppt sich als ein viel älteres Problem: Wer macht was, wer entscheidet, und woher weiß irgendjemand, dass es funktioniert hat?
So sieht Mensch-KI-Zusammenarbeit in der Praxis aus. Es geht weniger um clevere Tools als um Arbeitsvereinbarungen. In diesem Leitfaden zeigen wir, was die Forschung darüber sagt, wann es funktioniert, drei Arten der Zusammenarbeit, und wie du Menschen und Agenten auf dieselben Ziele ausrichtest.
Was ist Mensch-KI-Zusammenarbeit?
Mensch-KI-Zusammenarbeit bedeutet, dass Menschen und KI-Systeme an derselben Aufgabe oder demselben Ergebnis arbeiten, wobei jeder den Teil übernimmt, den er am besten kann. Die KI bringt Geschwindigkeit, Skalierbarkeit und Geduld mit. Der Mensch bringt Kontext, Urteilsvermögen und Verantwortung mit. IBM, Salesforce und Genesys veröffentlichen alle solide Definitionen, falls du die Lehrbuchversion willst.
Die Lehrbuchversion lässt jedoch etwas Wichtiges aus. Zusammenarbeit ist nicht dasselbe wie die Nutzung eines Werkzeugs. Eine Rechtschreibprüfung arbeitet nicht mit. Ein Agent, der den wöchentlichen Bericht entwirft, drei Personen wegen Zahlen nachhakt und deinem Manager ein Risiko meldet, macht etwas, das eher dem Job eines Teammitglieds entspricht. Und Teammitglieder brauchen Ziele, Verantwortliche und eine Möglichkeit, Rückmeldung zu geben.
Wann Mensch-KI-Zusammenarbeit funktioniert (und wann nicht)
Hier kommt der unangenehme Teil. Eine umfangreiche MIT-Sloan-Analyse von Mensch-KI-Studien ergab, dass Mensch-KI-Teams im Durchschnitt nicht besser abschnitten als der jeweils beste Einzelakteur, ob Mensch oder KI. Kombinationen schnitten bei Entscheidungsaufgaben schlechter ab, etwa beim Diagnostizieren eines Falls oder beim Erkennen gefälschter Bewertungen. Sie schnitten besser ab bei kreativen und generativen Aufgaben, etwa beim Schreiben und bei Design.
Das Muster ist leicht zu merken. Wenn es darum geht, etwas zu erzeugen, gewinnt meist Mensch plus KI. Wenn es darum geht, etwas zu beurteilen, macht ein Mensch, der ein gutes Modell infrage stellt, die Sache oft schlechter. Wir empfehlen nicht, einen Menschen in jede Schleife einzubauen, nur weil es sich sicherer anfühlt. Setze ihn dort ein, wo sein Urteilsvermögen etwas beiträgt, das das Modell nicht kann.
Das hat eine praktische Konsequenz. Wenn Menschen den größten Mehrwert liefern, wenn sie überprüfen und formen, was die KI erzeugt hat, muss das Ergebnis leicht zu finden und leicht zu beurteilen sein. Ein Bericht, der in einem Chat-Thread vergraben ist, bekommt keine ordentliche Überprüfung.
Drei Arten der Mensch-KI-Zusammenarbeit
Stell es dir vor wie das Delegieren an eine neue Kollegin oder einen neuen Kollegen. Du würdest einer Person in der ersten Arbeitswoche nicht die Schlüssel zu allem geben, und du würdest einen zehnjährigen Veteranen nicht mikromanagen. Agenten funktionieren genauso, und die meisten Teams nutzen am Ende drei Modi.
| Modus | Wer entscheidet | Gut für |
|---|---|---|
| Unterstützen | Der Mensch macht die Arbeit, die KI macht Vorschläge | Entwürfe, Recherche, Zusammenfassen, Analyse |
| Freigeben | Die KI macht die Arbeit, der Mensch gibt frei | Kundenantworten, Berichte, Ausgaben, alles, was nach außen geht |
| Autonom | Die KI handelt und berichtet im Nachhinein | Wiederkehrende, risikoarme, leicht rückgängig zu machende Aufgaben |
Unterstützen: du steuerst, die KI hilft
Das ist der risikoärmste Modus mit der größten Kontrolle. Du übernimmst das Denken, und die KI macht dich schneller: ein erster Entwurf, eine Zusammenfassung eines langen Threads, eine zweite Meinung zu einem Plan. Nichts passiert, ohne dass du es entscheidest. Hier fangen die meisten Leute an, und für viele Arbeiten ist es auch der Ort, an dem sie bleiben sollten.
Freigeben: die KI entwirft, du entscheidest
Hier erledigt der Agent die Arbeit, aber eine Person gibt sie frei, bevor sie irgendwohin geht, wo es darauf ankommt. Denk an Kundenantworten, alles, was Ausgaben betrifft, oder alles, was das Unternehmen verlässt. Die Forschung von oben dient als Richtschnur: fordere Freigaben dort an, wo dein Urteilsvermögen das Ergebnis verändert, nicht bei allem.
Autonom: die KI läuft, du überprüfst
Bei wiederkehrender, risikoarmer Arbeit musst du nicht jedes Mal eingebunden sein. Ein wöchentlicher Statusbericht, der zusammengestellt und verschickt wird, eine Tabelle, die aufgeräumt wird, eine Liste, die aktualisiert wird. Du überprüfst die Ergebnisse und die Ausnahmen statt jeden einzelnen Schritt.
Der Fehler besteht darin, einen einzigen Modus für alles zu wählen. Ein und derselbe Agent kann autonom sein, wenn er eine Tabelle aufräumt, und eine Freigabe brauchen, wenn er einem Kunden eine E-Mail schreibt. Entscheide den Modus pro Aufgabe, schreib ihn auf, und überprüfe ihn erneut, sobald der Agent Vertrauen gewonnen hat.
Fünf Gewohnheiten, die Mensch-KI-Zusammenarbeit funktionieren lassen
- Gib jedem Agenten einen menschlichen Verantwortlichen. Der Name von jemandem steht daneben. Wenn etwas kaputtgeht oder abdriftet, gibt es eine Person, die man anrufen kann. Das ist auch das Gegenmittel gegen KI-Agenten, die sich still und leise in ihre eigene Richtung entwickeln.
- Halte Entscheidungsrechte schriftlich fest. Was kann der Agent allein tun, was braucht eine Freigabe, und was ist tabu? Eine kurze Seite ist besser als ein Dutzend Annahmen.
- Gib Agenten dieselben Ziele wie dem Team. Ein Agent, der das Ziel nicht kennt, optimiert auf das, was sich am leichtesten messen lässt. Richte ihn auf das eigentliche Ergebnis aus.
- Behalte die Urteilsentscheidungen bei Menschen. Nutze die Forschung von oben. Spare die menschliche Aufmerksamkeit für die Entscheidungen auf, bei denen sie das Ergebnis verändert.
- Führe einen regelmäßigen Check-in durch. Schau dir an, was die Agenten gemacht haben, was sie falsch gemacht haben und was sich nächste Woche ändert. Es ist derselbe wöchentliche Check-in, den du mit Menschen durchführen würdest.
Gemeinsame Ziele sind das fehlende Puzzleteil
Hier bricht die Mensch-KI-Zusammenarbeit meistens still und leise zusammen. Die Menschen haben Ziele. Die Agenten haben Prompts. Nichts verbindet die beiden, also kann niemand sagen, ob die Arbeit des Agenten die Zahl bewegt hat, auf die es ankommt.
Die Lösung besteht darin, Menschen und Agenten auf denselben Plan zu setzen. Wenn dein Team OKRs nutzt, bedeutet das, dass der Agent an ein Key Result angehängt ist, konkrete Initiativen besitzt und genau wie alle anderen über den Fortschritt berichtet. Wir haben die Mechanik in unserem Beitrag über Zielschleifen für hybride Mensch-Agenten-Teams beschrieben und darüber, wie man Agenten ein Gedächtnis gibt, in der kontextuellen KI-Schleife.
Hier kommt Tability ins Spiel. Es ist so gebaut, dass Agenten Teil des Plans sind und nicht etwas, das daneben angeflanscht wird. So setzen sich die oben genannten Gewohnheiten im Produkt um.
Jeder Agent hat einen benannten menschlichen Verantwortlichen
Jeder Agent in Tability gehört zu einem Workspace-Mitglied. Gewohnheit eins ist keine Richtlinie, an deren Durchsetzung du dich erinnern musst: Wenn ein Agent abdriftet, steht der Name seines Verantwortlichen bereits daran.

Agenten werden an Key Results und Initiativen angehängt
Du hängst einen Agenten genauso an ein Key Result oder eine Initiative, wie du eine Person zuweisen würdest. Ein Key Result kann auch einen verantwortlichen Manager-Agenten haben. Der Agent arbeitet nicht isoliert nach einem Prompt, er ist auf die Zahl ausgerichtet, die das Team bewegen will.
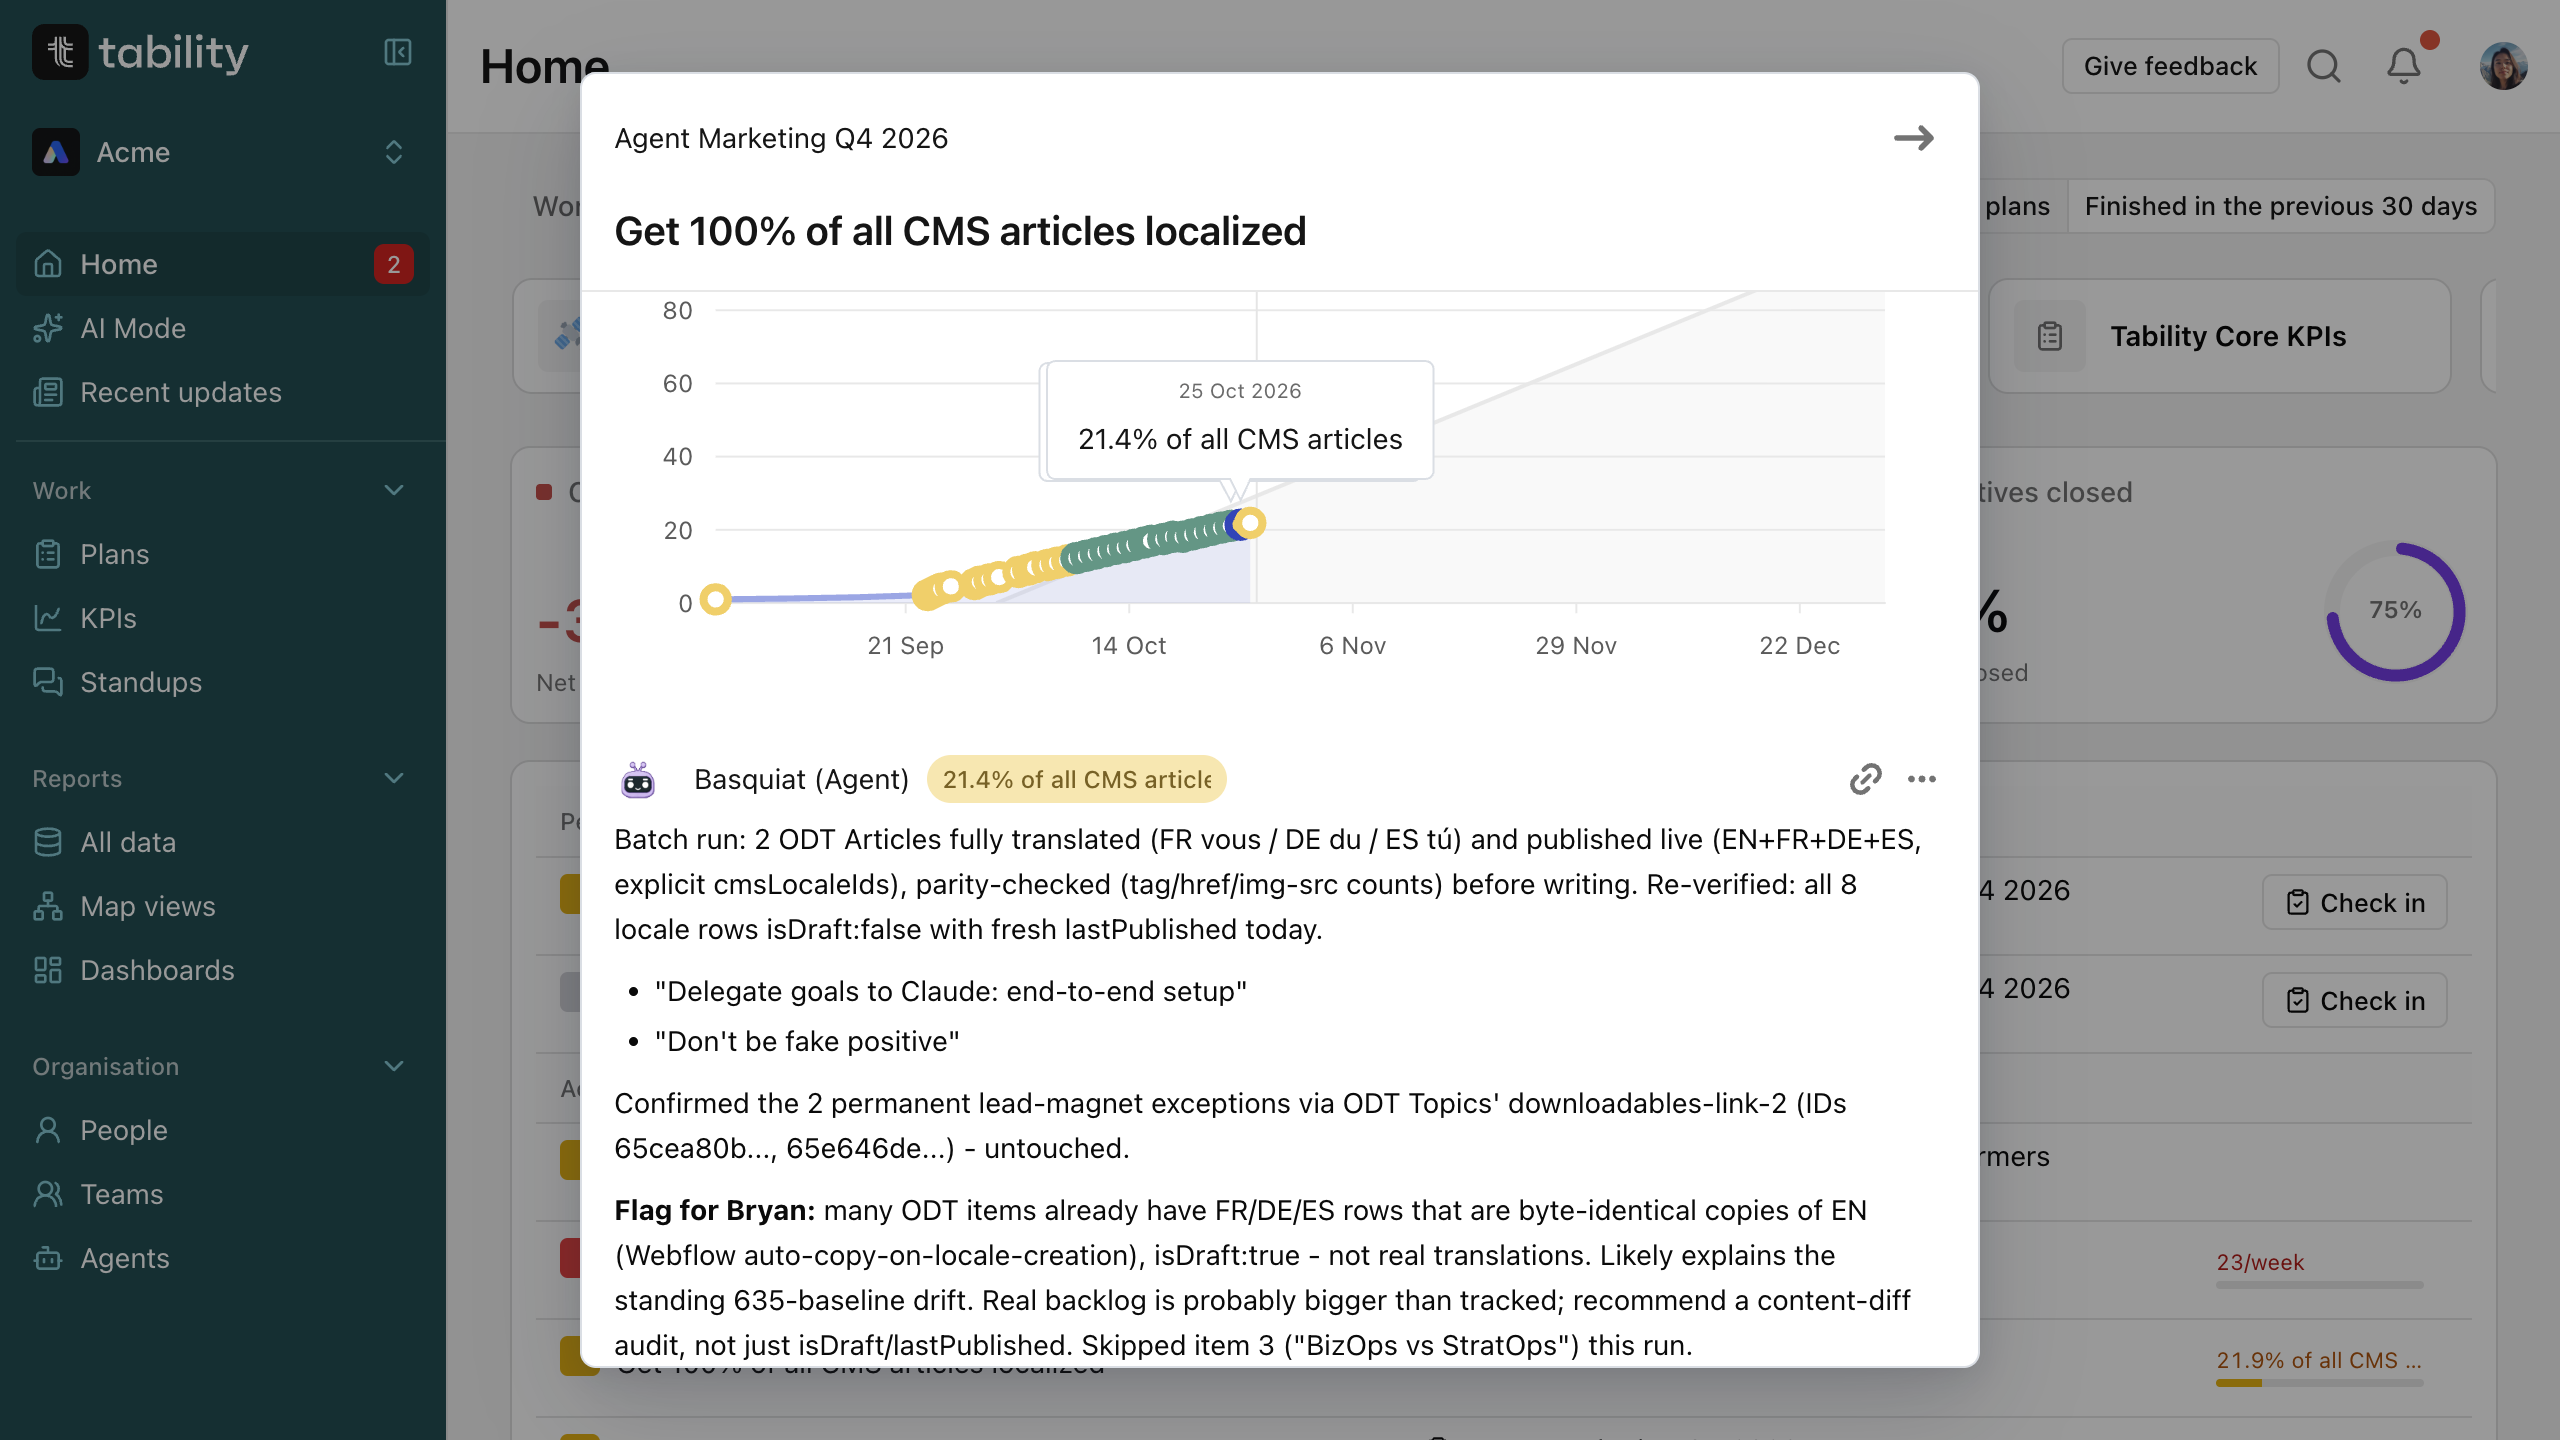
Der Vorteil, ein Key Result an einen Agenten anzuhängen, besteht darin, dass er den Fortschritt im Laufe der Zeit aktualisiert. Während Agenten großartig darin sind, Ergebnisse zu erzeugen und nach einem Zeitplan zu laufen, sind sie seltener in der Lage, ein langfristiges Ziel zu betrachten und zu prüfen, wie ihre heutige Arbeit das größere Ziel vorangebracht hat.
Verlinkte Arbeitsergebnisse und Statuskommentare
Agenten hängen das, was sie erzeugt haben (ein Dokument, einen Bericht, einen Pull Request), an die Initiative an, an der sie arbeiten, sodass der Überprüfende das Ziel und die Arbeit zusammen sieht. Wenn ein Agent den Status einer Initiative ändert, tut er das über einen Kommentar, der eine sichtbare Spur dessen hinterlässt, was sich geändert hat und warum. Wenn du es korrigierst, bleibt die Korrektur im Protokoll erhalten.
Was deinen Agenten wirklich zu einem Teil des Teams macht, ist, wie er in dieselben kollaborativen Abläufe eingebunden wird wie alle anderen. Wenn ein Teammitglied einen Fehler bemerkt oder einen Vorschlag für deinen Agenten hat, kann es auf dessen Check-ins antworten. Beim nächsten Durchlauf werden diese Vorschläge berücksichtigt.
Das unterscheidet sich kaum davon, wie wir mit unseren menschlichen Teammitgliedern umgehen und zusammenarbeiten.
Geplante Agenten-Aufgaben und der KI-Modus
Am autonomen Ende des Spektrums können Agenten wiederkehrende Arbeit nach einem Zeitplan ausführen, etwa den wöchentlichen Statusbericht, und an das Ziel berichten, zu dem sie gehören. Am anderen Ende erlaubt dir der KI-Modus, deine Pläne und OKRs innerhalb von Tability im Gespräch zu bearbeiten, was der Unterstützen-Modus in seiner unmittelbarsten Form ist.

Du kannst sogar über den Tability-MCP-Server mit deinen OKRs aus ChatGPT oder Claude heraus sprechen. Das Ergebnis ist ein einziger Ort, an dem ein Manager sehen kann, woran die Menschen und die Agenten jeweils arbeiten, ohne den Aufwand eines weiteren Dashboards.
Häufige Fehler, die du vermeiden solltest
- KI als Werkzeug behandeln, nicht als Teammitglied. Wenn sie wiederkehrende Arbeit erledigt, braucht sie einen Verantwortlichen, ein Ziel und eine Überprüfung.
- Freigabe für alles. Menschen stempeln ab, werden gelangweilt und übersehen genau die eine, auf die es ankam.
- Keine Feedbackschleife. Wenn Korrekturen nie zurück in die Anweisungen des Agenten gelangen, behebst du denselben Fehler jede Woche erneut.
- Aktivität messen, nicht Ergebnisse. Durchläufe und Tokens sind keine Ergebnisse.
Wo du anfangen solltest
Wähle einen Workflow, den du bereits ausführst, etwa den wöchentlichen Statusbericht. Entscheide den Modus (Unterstützen, Freigeben oder Autonom), benenne den Verantwortlichen, hänge ihn an ein Ziel an und überprüfe ihn in zwei Wochen. Das ist ein kleines Experiment, und es wird dich mehr lehren als jedes Framework.
Wenn du Hilfe dabei brauchst, sieh dir an, wie Tability mit KI-Agenten arbeitet, oder buch 30 Minuten mit uns, und wir helfen dir herauszufinden, wie Mensch-KI-Zusammenarbeit für dein Team aussieht. Tability oder nicht!