Dein Dashboard sagt dir, dass der Agent letzte Woche 214-mal gelaufen ist, eine vernünftige Menge an Tokens verbraucht und fast keine Fehler geworfen hat. Überall grün. Dann stellt jemand die naheliegende Frage: Hat das irgendetwas an der Zahl bewegt, auf die es ankommt? Und im Raum wird es still.
Das ist die Lücke, die man beim Monitoring der meisten KI-Agenten findet. Die Tools sind sehr gut darin, dir zu sagen, dass ein Agent lebt. Sie sind viel schwächer darin, dir zu sagen, ob der Agent überhaupt etwas bringt. Beides zählt, und beides braucht unterschiedliche Instrumente.
Hier also, wie du dir das Monitoring von KI-Agenten in drei Ebenen vorstellen kannst, was du in jeder davon verfolgst, und wo die meisten Teams eine Ebene zu früh aufhören.
Was ist KI-Agenten-Monitoring?
KI-Agenten-Monitoring bedeutet, zu verfolgen, was deine Agenten tun, wie zuverlässig sie es tun und was es kostet, damit du Probleme erkennst, bevor es ein Kunde oder Kollege tut. Das überschneidet sich stark mit KI-Agenten-Observability (Traces, Logs, Evaluierungen), worauf Anbieter wie Splunk, IBM und Sentry ihre Guides ausgerichtet haben. Observability hilft dir, einen einzelnen Agentenlauf zu debuggen. Monitoring hilft dir, die gesamte Flotte über die Zeit im Blick zu behalten.
Diese zweite Aufgabe wird schnell größer. Ein Agent ist ein Feature. Zehn Agenten, die fünf verschiedenen Personen gehören, kommen schon einem Team näher, und niemand würde ein Team führen, indem er Server-Logs liest. (Wenn du das schon spürst, erklärt unser Artikel über AI Agent Sprawl, wie es dazu kommt.)
Die drei Ebenen des KI-Agenten-Monitorings
Stell es dir vor wie das Monitoring einer neuen Mitarbeiterin. Du willst wissen, ob sie aufgetaucht ist, ob sie die Arbeit richtig macht, und ob die Arbeit dem Geschäft hilft. Agenten brauchen dieselben drei Checks.
| Ebene | Die Frage, die sie beantwortet | Was du verfolgst | Wer sie normalerweise verantwortet |
|---|---|---|---|
| 1. Health | Läuft der Agent? | Uptime, fehlgeschlagene Läufe, Latenz, Tool-Call-Fehler, Token-Verbrauch und Kosten | Engineering |
| 2. Behaviour | Macht er das Richtige? | Output-Qualität, Halluzinations- und Eskalationsraten, Guardrail-Treffer, auf welche Daten und Tools er zugegriffen hat | Engineering zusammen mit dem Business Owner |
| 3. Outcome | Bringt er ein Ziel voran? | Fortschritt beim Key Result, das er unterstützt, erledigte Arbeit, Entscheidungen, die er beeinflusst hat | Die Person, die für das Ziel verantwortlich ist |
Ebene 1: Health-Monitoring
Das ist die Ebene, die jeder zuerst baut, und das ist auch der richtige Startpunkt. Läuft der Agent nach Plan? Schlagen Tool-Calls fehl? Wie lange dauert ein Lauf, und was kostet er? Eine durchgehende Schleife, die über Nacht still dein Budget auffrisst, ist ein Health-Problem, und ein guter Alert erkennt das innerhalb von Minuten.
Am besten für: Ausfälle, Kostenspitzen und langsame Läufe aufspüren.
Ebene 2: Behaviour-Monitoring
Ein Agent kann vollkommen gesund sein und trotzdem falschliegen. Er ist gelaufen, hat keinen Fehler geworfen und selbstbewusst die falsche Zusammenfassung an den falschen Kanal geschickt. Behaviour-Monitoring schaut sich an, was der Agent produziert hat und was er anfassen durfte: stichprobenartige Output-Reviews, wie oft er an einen Menschen eskaliert, auf welche Systeme und Daten er zugegriffen hat, und ob er innerhalb seiner Berechtigungen geblieben ist.
Hier beginnt auch die Governance eine Rolle zu spielen, denn eine Monitoring-Spur ist der Nachweis, den du brauchst, wenn jemand fragt, was ein Agent getan hat und warum.
Am besten für: Qualität, Sicherheit und Audit-Trails.
Ebene 3: Outcome-Monitoring
Hier ist die Ebene, die die meisten Teams überspringen. Ein Agent, der gesund ist und sich gut verhält, kann trotzdem an etwas arbeiten, das keine Rolle spielt. Das Problem ist nicht der Agent, sondern dass ihn niemand mit einem Ziel verbunden hat.
Outcome-Monitoring stellt eine klarere Frage: Wofür war dieser Agent eigentlich da, und wird diese Sache besser? Wenn ein Agent existiert, um den Support-Rückstau zu verringern, ist der Rückstau die Messgröße. Wenn er wöchentliche Reports schreibt, ist die Messgröße, ob Führungskräfte sie lesen und danach handeln. Das ist dieselbe Disziplin, die wir bei Menschen anwenden: ein Ziel, ein Owner, und ein regelmäßiger Blick auf den Fortschritt. In OKR-Begriffen sollte jeder Agent auf das Key Result zeigen können, das er unterstützt.
Am besten für: zu entscheiden, welche Agenten du behältst, reparierst, ausbaust oder stilllegst.
Warum die ersten beiden Ebenen nicht reichen
Um ehrlich zu sein, sind Health- und Behaviour-Dashboards Grundvoraussetzung. Sie sagen dir, dass die Maschinerie läuft. Sie können dir nicht sagen, ob du die richtige Maschinerie laufen lässt.
Stell dir eine Flotte von Agenten vor, die auf dem Engineering-Dashboard alle gut aussehen. Einer produziert seit drei Monaten einen Report, den niemand öffnet. Ein anderer dupliziert Arbeit, die der Agent eines Kollegen schon erledigt. Ein dritter ist hervorragend, zielt aber auf ein Ziel, das letztes Quartal fallen gelassen wurde. Nichts davon zeigt sich in einem Latenz-Chart. Es zeigt sich, wenn jemand fragt, was die Flotte eigentlich erreicht, und das ist eine Management-Frage, keine Debugging-Frage.
Das ist das Argument dafür, das Ganze als Teil davon zu behandeln, wie du Agenten managst, nicht nur, wie du sie instrumentierst. Das ist auch, warum Enterprise-KI-Agenten-Projekte ins Stocken geraten: Das technische Monitoring steht, aber niemand verantwortet das Ergebnis.
So richtest du KI-Agenten-Monitoring in fünf Schritten ein
- Liste jeden Agenten auf und benenne einen Owner. Einen menschlichen Owner, kein Team. Wenn du die Person nicht benennen kannst, die den Anruf bekommen würde, hast du dein erstes Problem gefunden.
- Schreib das Ziel jedes Agenten auf. Ein Satz, verknüpft mit einer Kennzahl. „Zeit bis zur ersten Antwort verkürzen" schlägt „hilft beim Support".
- Richte Health-Alerts ein. Fehlgeschlagene Läufe, Kostenschwellen und stille Agenten (die, die hätten laufen sollen und es nicht taten).
- Stichprobe das Verhalten nach einem festen Rhythmus. Sieh dir jede Woche eine Handvoll Outputs an und verfolge Eskalations- und Fehlerraten, damit Qualitätsdrift früh auffällt.
- Überprüfe Outcomes in regelmäßigen Abständen. Nimm Agenten in denselben wöchentlichen Check-in-Rhythmus wie den Rest des Teams auf: Bewegt sich das Ziel, und verdient dieser Agent seinen Platz?
Tools für KI-Agenten-Monitoring
Der Markt teilt sich in zwei. Observability-Plattformen decken Ebene eins und zwei ab: Traces, Evaluierungen, Kosten- und Fehler-Tracking. Dahin greifen Engineers, und sie sind gut darin. Ebene drei ist ein anderer Job, und da sitzt Tability. Hier sind die Namen, die am häufigsten auftauchen, und welche Ebene jeder davon abdeckt.
| Tool | Ebenen | Am besten für |
|---|---|---|
| LangSmith | Health, Behaviour | Teams, die schon mit LangChain Agenten bauen und Tracing und Evaluierungen an einem Ort wollen |
| Langfuse | Health, Behaviour | Teams, die eine Open-Source-Option für Tracing, Evaluierungen und Prompt-Management wollen |
| Braintrust | Behaviour, Health | Teams, denen es vor allem darum geht, die Output-Qualität von Agenten vor und nach einem Release zu messen |
| Datadog | Health | Teams, die schon Datadog für ihre Infrastruktur nutzen und Agenten-Traces dort gleich mithaben wollen |
| Splunk Observability Cloud | Health | Größere Organisationen, die schon auf Splunk standardisiert sind |
| Sentry | Health | Entwickler, die Agenten-Spend-Dashboards und Alerts in einem Error-Tracking-Tool wollen, das sie schon nutzen |
| Maxim AI | Health, Behaviour | Debuggen und Evaluieren von Multi-Agenten-Workflows |
| Zenity | Behaviour | Security- und Governance-Teams, die im Blick behalten, worauf Agenten zugreifen können und was sie tun |
| Tability | Outcome | Teams, die jeden Agenten an ein Ziel, einen Owner und sichtbare Check-ins binden wollen |
Features in diesem Bereich ändern sich schnell, also prüf die aktuelle Doku jedes Anbieters, bevor du dich festlegst. Und du musst dich nicht auf eines festlegen. Die meisten Teams landen bei einem Observability-Tool für das technische Fundament und einer Goal-Tracking-Ebene für die Outcomes.
So überwachst du deine KI-Agenten mit Tability
Observability-Tools sagen dir, was ein Agent getan hat. Tabilitys Job ist, dir zu sagen, wofür er da war und ob er funktioniert. Deine Agenten laufen weiter dort, wo sie schon laufen, in Claude, ChatGPT oder Codex. Tability gibt jedem ein Profil, eine Reihe von Zielen, gegen die er berichtet, und einen Ort, an dem das ganze Team die Ergebnisse sehen kann. In der Praxis sind das vier Schritte: ein Profil anlegen, es an Arbeit binden, berichten lassen und die Leistung überprüfen.
1. Lege für jeden Agenten ein Profil an
In Tability „stellst du" einen Agenten „ein", indem du ein Profil anlegst. Zum Start brauchst du nur einen Namen, mit einer optionalen kurzen Beschreibung. Dann fügst du eine Stellenbeschreibung hinzu: seine Verantwortlichkeiten, die Outputs, die du bevorzugst, und wie er entscheiden soll, was als Nächstes kommt. Weise einen menschlichen Owner und ein Team zu, damit klar ist, wer verantwortlich ist. Halte jedes Profil spezifisch. Der Agent, der sich um das Blog-SEO kümmert, sollte nicht dieselben Anweisungen tragen wie der, der Social Outreach macht, genauso wie du nicht eine Stellenanzeige für zwei verschiedene Rollen schreiben würdest.

Um das Profil zu verbinden, kopierst du dessen Setup-Prompt in einen Assistenten, der schon mit dem Tability-MCP-Server verbunden ist, etwa Claude oder ChatGPT. Der Assistent berichtet dann über den Fortschritt der Arbeit, die an dieses Profil angehängt ist. Jeder im Workspace mit Bearbeitungsrechten kann das Profil aktualisieren, sodass die Person, die das Ergebnis verantwortet, die Anweisungen eines Agenten anpassen kann, ohne ein Entwicklertool zu öffnen. Agenten sind in jedem Tability-Premium-Plan enthalten, mit bis zu 10 Profilen pro Workspace.
2. Verknüpfe jeden Agenten mit der Arbeit, für die er zuständig ist
Ein Agent ohne Ziel ist genau das, was Outcome-Monitoring aufdecken soll. Verknüpfe also jedes Profil mit den Key Results und Initiativen, für die es zuständig ist. Jetzt stehen hinter „Ist dieser Agent nützlich?" echte Zahlen.

Der Overview-Tab des Profils verwandelt diese Verknüpfungen in eine „Current state"-Karte mit drei Kennzahlen:
- Net Confidence Score: die grünen Key Results minus die roten, als Anteil von allem, was der Agent besitzt. Grün bedeutet 30 oder mehr, Amber ist 0 bis 29, und Rot liegt unter 0. Die Farbe jedes Key Results kommt von der Confidence im letzten Check-in.
- KR-Fortschritt: der durchschnittliche Fortschritt über die Key Results, die dem Agenten zugeordnet sind.
- Erledigte Tasks: abgeschlossene Initiativen von allem, was zugeordnet ist, zum Beispiel 3 von 5.
Darunter stehen die Key Results und Initiativen, für die der Agent zuständig ist, dazu ein Feed seiner letzten Check-ins und Updates, damit du nicht nur siehst, wo die Dinge stehen, sondern auch, wie sie dorthin gekommen sind.
3. Lass Agenten berichten, ohne sie hinterherzujagen
Agenten schreiben ihre eigenen Check-ins zu Key Results und posten Updates zu Initiativen, inklusive eines Work State wie in progress, in review, blocked oder done. Jeder Eintrag ist mit dem Avatar des Agenten und der Person markiert, die ihn eingerichtet hat, sodass du immer weißt, was ein Mensch geschrieben hat und was ein Agent geschrieben hat.
Tability sorgt auch dafür, dass Agenten-Updates nützlich bleiben. Ein Agent kann pro Key Result und Tag einen neuen Check-in posten, und Updates bleiben kurz genug, um sie zu lesen. „On track" sagt dir nichts. Ein gutes Agenten-Update sagt, was sich bewegt hat, warum es sich bewegt hat, was blockiert ist und was als Nächstes passiert, obendrauf mit einer Confidence-Bewertung. Wenn etwas blockiert ist, markiert der Agent das und sagt, was er braucht.
Unser eigener Content-Agent arbeitet genauso. Bei jedem Lauf berichtet er, wie viele Beiträge fertig sind, welche in Review gegangen sind, was er als Nächstes ausgewählt hat und warum, und ob das Ziel grün, gelb oder rot ist. Wir haben über den Unterschied geschrieben in wie Tability-Agenten Statusberichte schreiben.
4. Überprüfe die Leistung über die ganze Flotte
Sobald mehrere Agenten berichten, ändert sich die Frage von „Ist er gelaufen?" zu „Wer liefert, und wer braucht Aufmerksamkeit?". Die Agents-Seite beantwortet das. Ihre „Work delivered"-Ansicht deckt die letzten 7 oder 30 Tage ab und zählt erledigte Tasks, gepostete Check-ins, bewegte Key Results und Confidence-Änderungen, mit einem Vergleich zur vorherigen Periode. Sie zeigt auch, wie viele deiner Agenten aktiv waren.
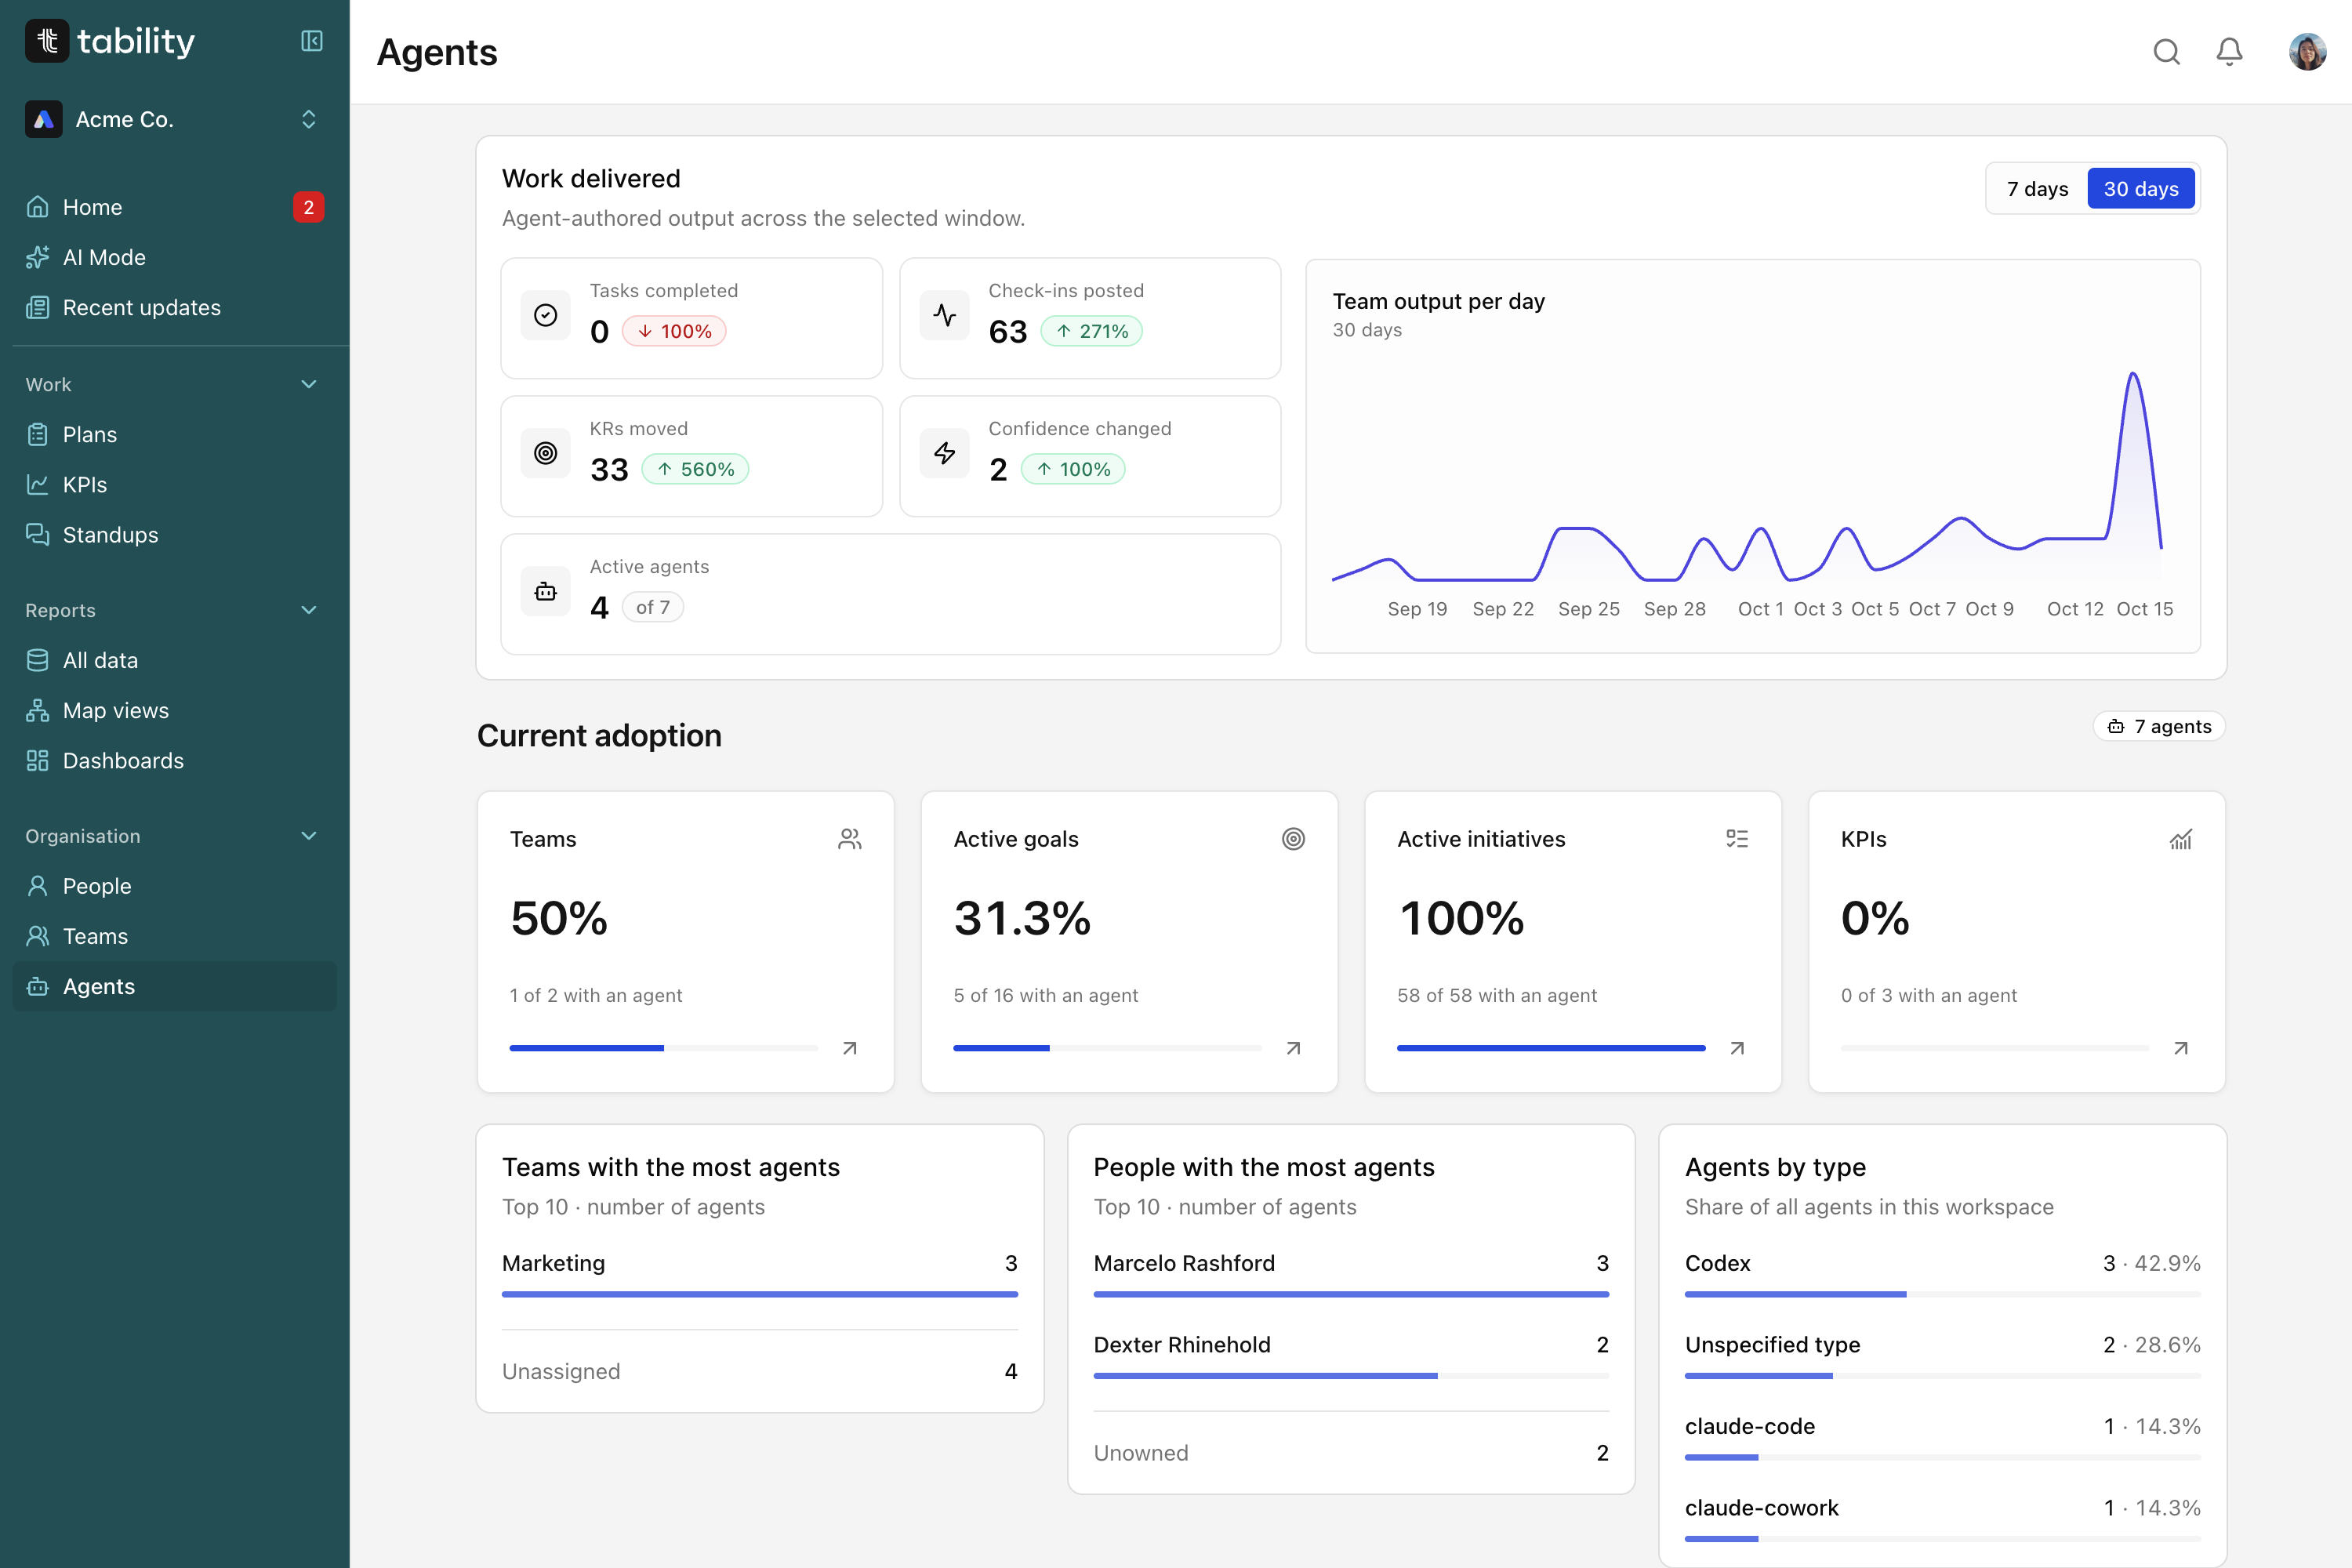
Darunter listet eine Tabelle jeden Agenten mit seinem Owner, KR-Fortschritt, Tasks, letztem Output und letzter Aktivität. Du kannst nach meist aktiv, Fortschritt oder braucht Aufmerksamkeit sortieren und nach aktiv, inaktiv oder braucht Aufmerksamkeit filtern. „Braucht Aufmerksamkeit" bedeutet mehr rote als grüne Key Results. „Inaktiv" bedeutet keinen Output im Zeitfenster. Wenn ein Ziel abgeschlossen ist oder ein Agent nichts mehr bewegt, ist das dein Stichwort, ihn stillzulegen oder auf etwas Neues anzusetzen. Das ist die „Stilllegen"-Entscheidung, zu der die meisten Flotten nie kommen.
Wenn du das Ganze auch nach oben berichten musst, zeigt unser Guide zum Messen von KI-Performance bei der Arbeit, wie du Aktivität, Kosten und Outcomes deinem Manager präsentierst.
5. Steuern mit Kommentaren
Wenn ein Agent Richtung braucht, kommentiere seinen Check-in oder antworte auf sein Initiative-Update, genau wie bei einem Kollegen. Der Agent liest dieses Feedback beim nächsten Lauf und passt sich an. Er reagiert nicht sofort, weil Tability deine Agenten nicht für dich ausführt. Zeitpläne und Ausführung bleiben in deinem Assistenten, wo du auch steuerst, wie oft ein Agent berichtet.
Wo Tability passt (und wo nicht)
Um es klar zu sagen: Tability ist kein Tracing-Tool. Es zeigt dir keine Traces auf Token-Ebene und sagt dir nicht, warum ein Tool-Call fehlgeschlagen ist, und es plant oder führt auch keine Agenten aus, also behalte deine Observability-Plattform und deinen Assistenten für diese Aufgaben. Was es hinzufügt, ist die Ebene, die sie auslassen: ein Ziel, ein Owner, ein Protokoll dessen, was der Agent berichtet hat, und ein Weg für das Team, zu steuern, alles an einem Ort, den jeder sehen kann. Das ist dieselbe Aufteilung, die StratOps-Teams schon für menschliche Arbeit nutzen, und Agent Orchestration zeigt, wie mehrere Agenten sich auf ein Ziel hin koordinieren.
Wenn du das mit deinen eigenen Agenten sehen willst, ist die Tability-KI-Agenten-Seite die schnellste Tour.
Häufige Fehler beim KI-Agenten-Monitoring
- Tokens statt Ergebnisse überwachen. Kosten pro Lauf sind nützlich. Kosten pro Outcome sind das, was du eigentlich willst, und wir zeigen, wie du KI-Performance bei der Arbeit misst, auf eine Art, der dein Manager vertrauen wird.
- Kein benannter Owner. Ein Alert ohne Owner ist eine Benachrichtigung, die niemand liest.
- Bei allem Alerts auslösen. Wenn jeder Lauf jemanden anpingt, wird er den Kanal stummschalten. Alert bei Ausnahmen und überprüfe den Rest nach einem festen Rhythmus.
- Einen Agenten nie stilllegen. Agenten sind leicht zu erstellen und unangenehm abzuschalten. Monitoring sollte „stilllegen" zu einer normalen Entscheidung machen.
- Es als einmaliges Setup behandeln. Ziele ändern sich. Prüf regelmäßig nach, ob jeder Agent noch auf eines zeigt, das es noch gibt.
Wo das dich zurücklässt
Zurück zu diesem grünen Dashboard. Es lag nicht falsch, es beantwortete nur die falsche Frage. Health- und Behaviour-Monitoring sagen dir, ob deine Agenten funktionieren. Outcome-Monitoring sagt dir, ob die Arbeit zählt, und das ist der Teil, der entscheidet, welche Agenten auf der Gehaltsliste bleiben.
Wenn du mehr als ein paar Agenten laufen hast und sie an echte Ziele binden willst, ist Tability ein unkomplizierter Startpunkt. Kostenlos registrieren, dir ansehen, wie Tability Agents funktionieren, oder 30 Minuten mit uns buchen, und wir helfen dir herauszufinden, wie Monitoring für deine Flotte aussieht. Ob mit Tability oder ohne, gib jedem Agenten ein Ziel und einen Owner.