Votre dashboard indique que l'agent a tourné 214 fois la semaine dernière, consommé un nombre raisonnable de tokens et déclenché presque aucune erreur. Tout est au vert. Puis quelqu'un pose la question évidente : est-ce que tout cela a fait bouger le chiffre qui compte vraiment ? Et la salle devient silencieuse.
C'est là le vide que l'on retrouve dans la plupart des dispositifs de monitoring d'agents IA. Les outils sont très bons pour vous dire qu'un agent est vivant. Ils sont beaucoup moins bons pour vous dire si cet agent sert à quelque chose. Les deux comptent, et ils demandent des instruments différents.
Voici donc comment envisager le monitoring des agents IA en trois niveaux, ce qu'il faut suivre à chacun, et où la plupart des équipes s'arrêtent un niveau trop tôt.
Qu'est-ce que le monitoring des agents IA ?
Le monitoring des agents IA consiste à suivre ce que font vos agents, avec quelle fiabilité ils le font, et ce que cela coûte, afin de détecter les problèmes avant qu'un client ou un collègue ne le fasse. Cela recoupe largement l'observabilité des agents IA (traces, logs, évaluations), un terrain sur lequel des éditeurs comme Splunk, IBM et Sentry ont concentré leurs guides. L'observabilité sert à déboguer l'exécution d'un seul agent. Le monitoring sert à garder un œil sur l'ensemble de la flotte dans la durée.
Cette seconde mission prend vite de l'ampleur. Un agent, c'est une fonctionnalité. Dix agents, détenus par cinq personnes différentes, se rapprochent d'une équipe, et personne ne piloterait une équipe en lisant des logs serveur. (Si vous ressentez déjà cela, notre article sur l'étalement des agents IA explique comment on en arrive là.)
Les trois niveaux du monitoring des agents IA
Pensez-y comme au suivi d'une nouvelle recrue. Vous voudriez savoir si elle est arrivée, si elle fait correctement le travail, et si ce travail aide l'entreprise. Les agents ont besoin des trois mêmes vérifications.
| Niveau | La question à laquelle il répond | Ce que vous suivez | Qui en est généralement responsable |
|---|---|---|---|
| 1. Santé | L'agent fonctionne-t-il ? | Disponibilité, exécutions échouées, latence, erreurs d'appels d'outils, usage de tokens et coût | Ingénierie |
| 2. Comportement | Fait-il ce qu'il faut ? | Qualité des résultats, taux d'hallucination et d'escalade, déclenchements de garde-fous, données et outils auxquels il a accédé | Ingénierie avec le responsable métier |
| 3. Résultat | Fait-il avancer un objectif ? | Progression du Key Result qu'il soutient, travail accompli, décisions qu'il a éclairées | La personne responsable de l'objectif |
Niveau 1 : le monitoring de santé
C'est le niveau que tout le monde construit en premier, et c'est le bon point de départ. L'agent tourne-t-il selon le planning prévu ? Des appels d'outils échouent-ils ? Combien de temps prend une exécution, et combien coûte chacune ? Une boucle incontrôlée qui épuise discrètement votre budget pendant la nuit est un problème de santé, et une bonne alerte le détecte en quelques minutes.
Idéal pour : repérer les pannes, les pics de coût et les exécutions lentes.
Niveau 2 : le monitoring du comportement
Un agent peut être parfaitement en bonne santé et pourtant se tromper. Il a tourné, il n'a pas renvoyé d'erreur, et il a envoyé avec assurance le mauvais résumé au mauvais canal. Le monitoring du comportement observe ce que l'agent a produit et ce qu'il a eu le droit de toucher : des revues d'échantillons de résultats, la fréquence à laquelle il escalade vers un humain, les systèmes et données auxquels il a accédé, et s'il est resté dans le cadre de ses permissions.
C'est aussi là que la gouvernance commence à compter, car une trace de monitoring est la preuve que vous voudrez produire quand quelqu'un demandera ce qu'un agent a fait et pourquoi.
Idéal pour : la qualité, la sécurité et les pistes d'audit.
Niveau 3 : le monitoring des résultats
Voici le niveau que la plupart des équipes sautent. Un agent en bonne santé et bien élevé peut malgré tout travailler sur quelque chose qui n'a pas d'importance. Le problème n'est pas l'agent, c'est que personne ne l'a relié à un objectif.
Le monitoring des résultats pose une question plus directe : à quoi cet agent servait-il, et est-ce que cette chose s'améliore ? Si un agent existe pour réduire l'arriéré de support, la mesure est cet arriéré. S'il rédige des rapports hebdomadaires, la mesure est de savoir si les dirigeants les lisent et agissent en conséquence. C'est la même discipline que celle que nous appliquons aux personnes : un objectif, un responsable, et un suivi régulier de la progression. En termes d'OKR, chaque agent devrait pouvoir pointer vers le Key Result qu'il soutient.
Idéal pour : décider quels agents conserver, corriger, développer ou retirer.
Pourquoi les deux premiers niveaux ne suffisent pas
Pour être franc, les tableaux de bord de santé et de comportement sont la base attendue. Ils vous disent que la mécanique fonctionne. Ils ne peuvent pas vous dire si vous faites tourner la bonne mécanique.
Imaginez une flotte d'agents qui ont tous l'air en ordre sur le tableau de bord technique. L'un d'eux produit depuis trois mois un rapport que personne n'ouvre. Un autre fait en double un travail que l'agent d'un collègue réalise déjà. Un troisième est excellent, mais il vise un objectif qui a été abandonné le trimestre dernier. Rien de tout cela n'apparaît sur un graphique de latence. Cela apparaît quand quelqu'un demande ce que la flotte accomplit réellement, ce qui est une question de management, pas de débogage.
C'est l'argument pour traiter cela comme une partie de la façon dont vous managez vos agents, et pas seulement de la façon dont vous les instrumentez. C'est aussi pourquoi les déploiements d'agents IA en entreprise s'enlisent : le monitoring technique est en place, mais personne n'est responsable du résultat.
Comment mettre en place le monitoring des agents IA en cinq étapes
- Listez chaque agent et nommez un responsable. Un responsable humain, pas une équipe. Si vous ne pouvez pas nommer la personne qui recevrait l'appel, vous venez de trouver votre premier problème.
- Écrivez l'objectif de chaque agent. Une phrase, reliée à une métrique. « Réduire le délai jusqu'à la première réponse » vaut mieux que « aider le support ».
- Mettez en place des alertes de santé. Exécutions échouées, seuils de coût et agents silencieux (ceux qui auraient dû tourner et ne l'ont pas fait).
- Échantillonnez le comportement selon un calendrier régulier. Passez en revue une poignée de résultats chaque semaine et suivez les taux d'escalade et d'erreur, pour repérer tôt toute dérive de qualité.
- Passez en revue les résultats à un rythme régulier. Intégrez les agents au même rythme de point hebdomadaire que le reste de l'équipe : l'objectif avance-t-il, et cet agent mérite-t-il sa place ?
Outils pour le monitoring des agents IA
Le marché se divise en deux. Les plateformes d'observabilité couvrent les niveaux un et deux : traces, évaluations, suivi des coûts et des erreurs. C'est vers elles que se tournent les ingénieurs, et elles font ça bien. Le niveau trois est un métier différent, et c'est là que se situe Tability. Voici les noms qui reviennent le plus souvent, et quel niveau chacun couvre.
| Outil | Niveaux | Idéal pour |
|---|---|---|
| LangSmith | Santé, comportement | Les équipes qui construisent déjà des agents avec LangChain et veulent traces et évaluations au même endroit |
| Langfuse | Santé, comportement | Les équipes qui veulent une option open source pour les traces, les évaluations et la gestion des prompts |
| Braintrust | Comportement, santé | Les équipes qui tiennent surtout à mesurer la qualité des résultats d'un agent avant et après une mise en production |
| Datadog | Santé | Les équipes qui utilisent déjà Datadog pour leur infrastructure et veulent les traces d'agents au même endroit |
| Splunk Observability Cloud | Santé | Les grandes organisations déjà standardisées sur Splunk |
| Sentry | Santé | Les développeurs qui veulent des tableaux de bord de dépenses d'agents et des alertes dans un outil de suivi des erreurs qu'ils utilisent déjà |
| Maxim AI | Santé, comportement | Déboguer et évaluer des workflows multi-agents |
| Zenity | Comportement | Les équipes sécurité et gouvernance qui surveillent ce que les agents peuvent faire et à quoi ils peuvent accéder |
| Tability | Résultat | Les équipes qui veulent que chaque agent soit relié à un objectif, un responsable et des points d'avancement visibles |
Les fonctionnalités de ce secteur évoluent vite, vérifiez donc la documentation actuelle de chaque éditeur avant de vous engager. Et vous n'êtes pas obligé d'en choisir un seul. La plupart des équipes finissent avec un outil d'observabilité pour la plomberie technique et une couche de suivi d'objectifs pour les résultats.
Comment surveiller vos agents IA avec Tability
Les outils d'observabilité vous disent ce qu'un agent a fait. Le rôle de Tability est de vous dire à quoi il servait, et s'il fonctionne. Vos agents continuent de tourner là où ils tournent déjà, dans Claude, ChatGPT ou Codex. Tability donne à chacun un profil, un ensemble d'objectifs sur lesquels rendre des comptes, et un endroit où toute l'équipe peut voir les résultats. En pratique, cela se résume à quatre actions : créer un profil, le relier à du travail, le laisser rendre compte, et évaluer sa performance.
1. Créez un profil pour chaque agent
Dans Tability, vous « embauchez » un agent en créant un profil. Pour commencer, il ne faut qu'un nom, avec une courte description facultative. Ajoutez ensuite une fiche de poste : ses responsabilités, les résultats que vous préférez et comment il doit décider de la suite. Attribuez un responsable humain et une équipe pour que la redevabilité soit claire. Gardez chaque profil spécifique. L'agent qui s'occupe du SEO de votre blog ne devrait pas porter les mêmes instructions que celui qui gère la prospection sociale, de la même façon que vous n'écririez pas une seule offre d'emploi pour deux rôles différents.

Pour connecter le profil, copiez son prompt de configuration dans un assistant déjà relié au serveur MCP Tability, comme Claude ou ChatGPT. L'assistant rend alors compte de l'avancement du travail rattaché à ce profil. Toute personne de l'espace de travail disposant d'un accès en modification peut mettre à jour le profil, de sorte que la personne responsable du résultat peut ajuster les instructions d'un agent sans ouvrir d'outil de développement. Les agents sont inclus dans chaque offre Tability Premium, avec jusqu'à 10 profils par espace de travail.
2. Reliez chaque agent au travail dont il est responsable
Un agent sans objectif est exactement ce que le monitoring des résultats est censé repérer. Reliez donc chaque profil aux key results et initiatives dont il est responsable. Désormais, « cet agent est-il utile ? » a des chiffres derrière lui.

L'onglet Overview du profil transforme ces liens en une carte « État actuel » avec trois mesures :
- Net Confidence Score : les key results verts moins les rouges, en proportion de tout ce que l'agent possède. Vert signifie 30 ou plus, ambre va de 0 à 29, et rouge est en dessous de 0. La couleur de chaque key result provient de la confiance indiquée lors de son dernier point d'avancement.
- Progression des KR : la progression moyenne des key results rattachés à l'agent.
- Tâches terminées : initiatives clôturées sur l'ensemble de celles rattachées, par exemple 3 sur 5.
En dessous figurent les key results et initiatives dont l'agent est responsable, ainsi qu'un fil de ses points d'avancement et mises à jour récents, pour que vous puissiez voir non seulement où en sont les choses, mais comment on en est arrivé là.
3. Laissez les agents rendre compte sans avoir à les relancer
Les agents rédigent eux-mêmes leurs points d'avancement sur les key results et publient des mises à jour sur les initiatives, avec un état d'avancement tel que en cours, en revue, bloqué ou terminé. Chaque élément porte l'avatar de l'agent et la personne qui l'a configuré, pour que vous sachiez toujours ce qu'un humain a écrit et ce qu'un agent a écrit.
Tability veille aussi à ce que les mises à jour des agents restent utiles. Un agent peut publier un nouveau point d'avancement par key result et par jour, et les mises à jour restent assez courtes pour se lire facilement. « Sur la bonne voie » ne vous dit rien. Une bonne mise à jour d'agent indique ce qui a bougé, pourquoi cela a bougé, ce qui est bloqué et ce qui se passe ensuite, avec une note de confiance en plus. Quand quelque chose est bloqué, l'agent le signale et indique de quoi il a besoin.
Notre propre agent de contenu fonctionne ainsi. À chaque exécution, il rapporte combien d'articles sont terminés, lesquels sont passés en revue, ce qu'il a choisi de faire ensuite et pourquoi, et si l'objectif est vert, jaune ou rouge. Nous avons détaillé cette différence dans notre article sur la façon dont les Agents Tability rédigent leurs rapports d'avancement.
4. Évaluez la performance de toute la flotte
Une fois que plusieurs agents rendent compte, la question passe de « a-t-il tourné ? » à « qui livre, et qui a besoin d'attention ? ». La page Agents y répond. Sa vue « Travail livré » couvre les 7 ou 30 derniers jours et compte les tâches terminées, les points d'avancement publiés, les key results qui ont bougé et les changements de confiance, avec une comparaison à la période précédente. Elle montre aussi combien de vos agents étaient actifs.
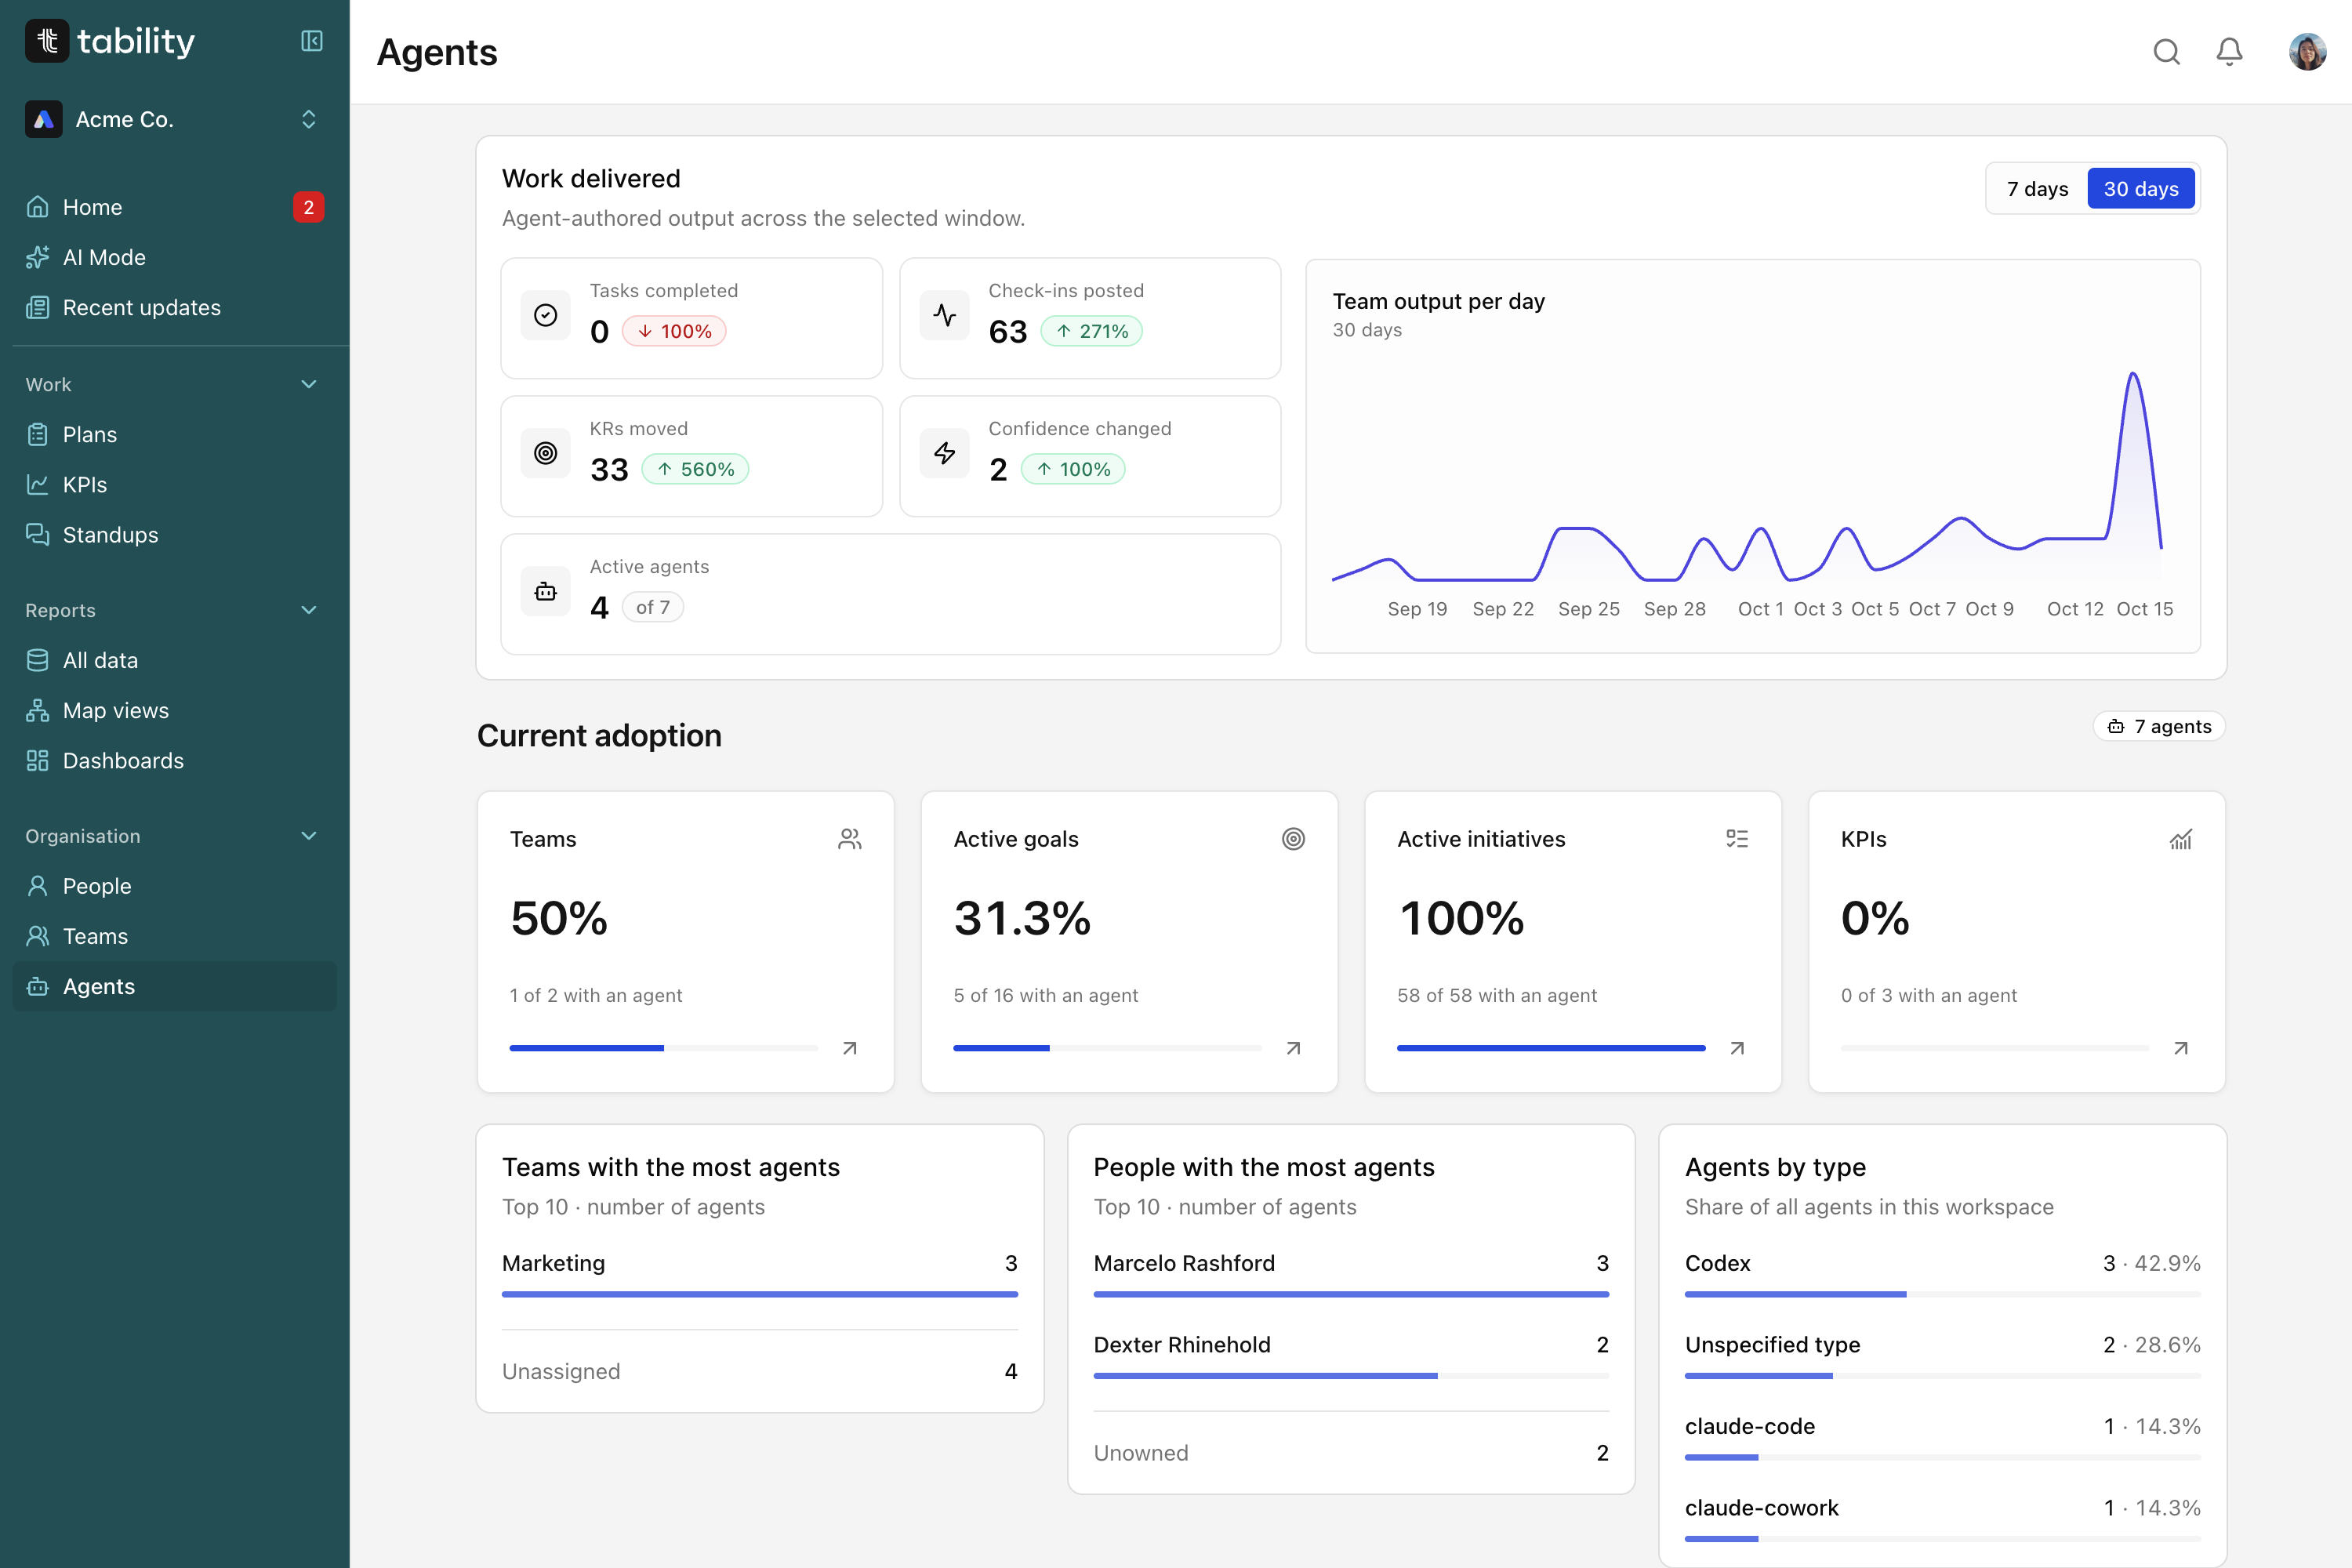
En dessous, un tableau liste chaque agent avec son responsable, la progression des KR, les tâches, les résultats récents et la dernière activité. Vous pouvez trier par activité, progression ou besoin d'attention, et filtrer sur les agents actifs, inactifs ou nécessitant une attention. « Nécessite une attention » signifie plus de key results rouges que verts. « Inactif » signifie aucun résultat sur la période. Quand un objectif se termine ou qu'un agent ne fait plus avancer quoi que ce soit, c'est le signal pour le retirer ou le réorienter vers autre chose. C'est la décision de « le retirer » que la plupart des flottes ne prennent jamais le temps de prendre.
Si vous devez aussi rendre compte de tout cela à votre hiérarchie, notre guide sur la mesure de la performance de l'IA au travail explique comment présenter l'activité, le coût et les résultats à votre manager.
5. Pilotez avec des commentaires
Quand un agent a besoin d'être recadré, commentez son point d'avancement ou répondez à sa mise à jour d'initiative, de la même façon que vous le feriez avec un collègue. L'agent lit ce retour la prochaine fois qu'il s'exécute, et s'ajuste. Il ne répondra pas instantanément, car Tability n'exécute pas vos agents à votre place. Les plannings et l'exécution restent dans votre assistant, qui est aussi l'endroit où vous contrôlez la fréquence à laquelle un agent rend compte.
Où Tability se situe (et où il ne se situe pas)
Pour être clair, Tability n'est pas un outil de traçage. Il ne vous montrera pas de traces au niveau des tokens et ne vous dira pas pourquoi un appel d'outil a échoué, et il ne planifie ni n'exécute les agents, donc gardez votre plateforme d'observabilité et votre assistant pour ces tâches. Ce qu'il ajoute, c'est le niveau qu'ils sautent : un objectif, un responsable, un historique de ce que l'agent a rapporté et un moyen pour l'équipe de le piloter, le tout au même endroit, visible par tous. C'est la même répartition que les équipes StratOps utilisent déjà pour le travail humain, et l'orchestration d'agents explique comment plusieurs agents se coordonnent vers un même objectif.
Si vous voulez le voir avec vos propres agents, la page des agents IA Tability est le tour le plus rapide.
Erreurs courantes dans le monitoring des agents IA
- Surveiller les tokens plutôt que les résultats. Le coût par exécution est utile. Le coût par résultat est ce que vous voulez réellement, et nous montrons comment mesurer la performance de l'IA au travail d'une manière que votre manager jugera fiable.
- Aucun responsable nommé. Une alerte sans responsable est une notification que personne ne lit.
- Alerter sur tout. Si chaque exécution notifie quelqu'un, cette personne finira par couper le canal. Alertez sur les exceptions et passez le reste en revue selon un calendrier régulier.
- Ne jamais retirer un agent. Les agents sont faciles à créer et difficiles à arrêter. Le monitoring devrait faire du « le retirer » une décision normale.
- Le traiter comme une configuration ponctuelle. Les objectifs changent. Vérifiez régulièrement que chaque agent pointe toujours vers un objectif qui existe encore.
Ce qu'il vous reste à faire
Retour à ce tableau de bord vert. Il n'avait pas tort, il répondait simplement à la mauvaise question. Le monitoring de santé et de comportement vous dit si vos agents fonctionnent. Le monitoring des résultats vous dit si le travail compte vraiment, et c'est cette partie qui décide quels agents restent sur la liste de paie.
Si vous faites tourner plus de quelques agents et voulez qu'ils rendent des comptes sur de vrais objectifs, Tability est un point de départ simple. Inscrivez-vous gratuitement, découvrez comment fonctionnent les Agents Tability, ou réservez 30 minutes avec nous et nous vous aiderons à déterminer à quoi ressemble le monitoring pour votre flotte. Avec ou sans Tability, donnez à chaque agent un objectif et un responsable.