Tu dashboard dice que el agente se ejecutó 214 veces la semana pasada, consumió una cantidad razonable de tokens y apenas lanzó errores. Todo en verde. Entonces alguien hace la pregunta obvia: ¿todo eso movió el número que de verdad importa? Y la sala se queda en silencio.
Ahí está el vacío en la mayoría de los sistemas de monitoreo de agentes de IA. Las herramientas son muy buenas diciéndote que un agente está vivo. Son mucho más débiles diciéndote si ese agente sirve para algo. Ambas cosas importan, y necesitan instrumentos distintos.
Así que aquí tienes cómo pensar el monitoreo de agentes de IA en tres capas, qué seguir en cada una, y dónde la mayoría de los equipos se detienen una capa demasiado pronto.
¿Qué es el monitoreo de agentes de IA?
El monitoreo de agentes de IA es la práctica de seguir lo que hacen tus agentes, con qué fiabilidad lo hacen y qué cuesta, para que puedas detectar problemas antes que un cliente o un compañero. Se solapa mucho con la observabilidad de agentes de IA (trazas, logs, evaluaciones), que es donde proveedores como Splunk, IBM y Sentry han centrado sus guías. La observabilidad te sirve para depurar la ejecución de un solo agente. El monitoreo te sirve para vigilar toda la flota a lo largo del tiempo.
Esa segunda tarea crece rápido. Un agente es una función. Diez agentes, propiedad de cinco personas distintas, se parecen más a un equipo, y nadie dirigiría un equipo leyendo logs de servidor. (Si ya sientes esto, nuestro artículo sobre la proliferación de agentes de IA explica cómo se llega ahí.)
Las tres capas del monitoreo de agentes de IA
Piénsalo como el seguimiento de una nueva incorporación. Querrías saber si se presentó, si está haciendo el trabajo correctamente, y si ese trabajo está ayudando al negocio. Los agentes necesitan las mismas tres comprobaciones.
| Capa | La pregunta que responde | Qué sigues | Quién suele ser responsable |
|---|---|---|---|
| 1. Salud | ¿Está funcionando el agente? | Uptime, ejecuciones fallidas, latencia, errores de llamadas a herramientas, uso de tokens y coste | Ingeniería |
| 2. Comportamiento | ¿Está haciendo lo correcto? | Calidad del output, tasas de alucinación y escalado, saltos de guardrails, qué datos y herramientas tocó | Ingeniería junto con el responsable de negocio |
| 3. Resultado | ¿Está moviendo un objetivo? | Progreso del Key Result que respalda, trabajo completado, decisiones que ayudó a tomar | La persona responsable del objetivo |
Capa 1: monitoreo de salud
Esta es la capa que todo el mundo construye primero, y es el lugar correcto para empezar. ¿Está el agente ejecutándose según lo previsto? ¿Fallan las llamadas a herramientas? ¿Cuánto tarda una ejecución, y cuánto cuesta cada una? Un bucle descontrolado que se gasta tu presupuesto en silencio durante la noche es un problema de salud, y una buena alerta lo detecta en minutos.
Ideal para: detectar averías, picos de coste y ejecuciones lentas.
Capa 2: monitoreo de comportamiento
Un agente puede estar perfectamente sano y aun así equivocarse. Se ejecutó, no dio error, y envió con total confianza el resumen equivocado al canal equivocado. El monitoreo de comportamiento mira lo que el agente produjo y lo que tuvo permiso para tocar: revisiones de muestras de output, con qué frecuencia escala a un humano, a qué sistemas y datos accedió, y si se mantuvo dentro de sus permisos.
Aquí es también donde empieza a importar el gobierno (governance), porque un rastro de monitoreo es la prueba que querrás tener cuando alguien pregunte qué hizo un agente y por qué.
Ideal para: calidad, seguridad y rastros de auditoría.
Capa 3: monitoreo de resultados
Aquí está la capa que la mayoría de los equipos se saltan. Un agente sano y bien comportado puede seguir trabajando en algo que no importa. El problema no es el agente, es que nadie lo conectó con un objetivo.
El monitoreo de resultados hace una pregunta más directa: ¿para qué servía en realidad este agente, y está mejorando esa cosa? Si un agente existe para reducir el backlog de soporte, la medida es el backlog. Si escribe informes semanales, la medida es si los líderes los leen y actúan. Es la misma disciplina que aplicamos a las personas: un objetivo, un responsable, y una mirada regular al progreso. En términos de OKR, cada agente debería poder señalar el Key Result que respalda.
Ideal para: decidir qué agentes mantener, arreglar, ampliar o retirar.
Por qué las dos primeras capas no bastan
Para ser sincero, los dashboards de salud y comportamiento son lo mínimo esperado. Te dicen que la maquinaria funciona. No pueden decirte si estás usando la maquinaria correcta.
Imagina una flota de agentes que en el dashboard de ingeniería se ven todos bien. Uno lleva tres meses generando un informe que nadie abre. Otro está duplicando un trabajo que el agente de un compañero ya hace. Un tercero es excelente, pero apunta a un objetivo que se abandonó el trimestre pasado. Nada de eso aparece en un gráfico de latencia. Aparece cuando alguien pregunta qué está logrando la flota, y eso es una pregunta de gestión, no de depuración.
Ese es el argumento para tratar esto como parte de cómo gestionas tus agentes, y no solo de cómo los instrumentas. También es por eso que los despliegues de agentes de IA en la empresa se estancan: el monitoreo técnico está en marcha, pero nadie es responsable del resultado.
Cómo configurar el monitoreo de agentes de IA en cinco pasos
- Lista cada agente y nombra un responsable. Un responsable humano, no un equipo. Si no puedes nombrar a la persona que recibiría la llamada, acabas de encontrar tu primer problema.
- Escribe el objetivo de cada agente. Una frase, ligada a una métrica. «Reducir el tiempo hasta la primera respuesta» le gana a «ayudar con el soporte».
- Configura alertas de salud. Ejecuciones fallidas, umbrales de coste y agentes silenciosos (los que deberían haberse ejecutado y no lo hicieron).
- Muestrea el comportamiento con una frecuencia fija. Revisa un puñado de outputs cada semana y sigue las tasas de escalado y error, para detectar pronto cualquier deriva de calidad.
- Revisa los resultados con una cadencia regular. Incorpora a los agentes al mismo ritmo de check-in semanal que el resto del equipo: ¿se está moviendo el objetivo, y se está ganando este agente su lugar?
Herramientas para el monitoreo de agentes de IA
El mercado se divide en dos. Las plataformas de observabilidad cubren las capas uno y dos: trazas, evaluaciones, seguimiento de coste y errores. Son lo que buscan los ingenieros, y se les da bien. La capa tres es un trabajo distinto, y ahí es donde se sitúa Tability. Aquí están los nombres que más aparecen, y qué capa cubre cada uno.
| Herramienta | Capas | Ideal para |
|---|---|---|
| LangSmith | Salud, comportamiento | Equipos que ya construyen agentes con LangChain y quieren tracing y evaluaciones en un solo lugar |
| Langfuse | Salud, comportamiento | Equipos que quieren una opción open source para tracing, evaluaciones y gestión de prompts |
| Braintrust | Comportamiento, salud | Equipos a los que les importa sobre todo medir la calidad del output del agente antes y después de un release |
| Datadog | Salud | Equipos que ya usan Datadog para su infraestructura y quieren trazas de agentes junto a ella |
| Splunk Observability Cloud | Salud | Organizaciones grandes ya estandarizadas en Splunk |
| Sentry | Salud | Desarrolladores que quieren dashboards de gasto de agentes y alertas dentro de una herramienta de seguimiento de errores que ya usan |
| Maxim AI | Salud, comportamiento | Depurar y evaluar flujos de trabajo multiagente |
| Zenity | Comportamiento | Equipos de seguridad y gobierno que vigilan a qué pueden acceder los agentes y qué pueden hacer |
| Tability | Resultado | Equipos que quieren que cada agente esté ligado a un objetivo, un responsable y check-ins visibles |
Las funciones en este espacio cambian rápido, así que revisa la documentación actual de cada proveedor antes de decidirte. Y no tienes que elegir solo una. La mayoría de los equipos terminan con una herramienta de observabilidad para la fontanería técnica y una capa de seguimiento de objetivos para los resultados.
Cómo monitorear tus agentes de IA con Tability
Las herramientas de observabilidad te dicen qué hizo un agente. El trabajo de Tability es decirte para qué servía, y si está funcionando. Tus agentes siguen ejecutándose donde ya se ejecutan, en Claude, ChatGPT o Codex. Tability le da a cada uno un perfil, un conjunto de objetivos sobre los que reportar, y un lugar donde todo el equipo puede ver los resultados. En la práctica son cuatro pasos: crear un perfil, ligarlo a trabajo, dejarlo reportar, y revisar su rendimiento.
1. Crea un perfil para cada agente
En Tability «contratas» a un agente creando un perfil. Para empezar solo hace falta un nombre, con una descripción corta opcional. Luego añade una descripción del puesto: sus responsabilidades, los outputs que prefieres y cómo debería decidir qué hacer a continuación. Asigna un responsable humano y un equipo para que quede claro quién rinde cuentas. Mantén cada perfil específico. El agente que se encarga del SEO de tu blog no debería llevar las mismas instrucciones que el que gestiona el alcance social, igual que no escribirías una sola oferta de empleo para dos roles distintos.

Para conectar el perfil, copia su prompt de configuración en un asistente que ya tenga conectado el servidor MCP de Tability, como Claude o ChatGPT. El asistente entonces reporta el progreso del trabajo ligado a ese perfil. Cualquiera en el workspace con acceso de edición puede actualizar el perfil, así que la persona responsable del resultado puede ajustar las instrucciones de un agente sin abrir ninguna herramienta de desarrollo. Los agentes están incluidos en todos los planes Tability Premium, con hasta 10 perfiles por workspace.
2. Liga cada agente al trabajo del que es responsable
Un agente sin objetivo es exactamente lo que el monitoreo de resultados está pensado para detectar. Así que liga cada perfil a los key results e iniciativas de los que es responsable. Ahora «¿es útil este agente?» tiene números detrás.

La pestaña Overview del perfil convierte esas conexiones en una tarjeta de «estado actual» con tres medidas:
- Net Confidence Score: los key results verdes menos los rojos, como proporción de todo lo que posee el agente. Verde significa 30 o más, ámbar es de 0 a 29, y rojo es menos de 0. El color de cada key result viene de la confianza en su último check-in.
- Progreso de KR: el progreso medio de los key results ligados al agente.
- Tareas completadas: iniciativas cerradas sobre el total de las ligadas, por ejemplo 3 de 5.
Debajo de eso están los key results e iniciativas de los que el agente es responsable, además de un feed de sus check-ins y actualizaciones recientes, para que puedas ver no solo cómo están las cosas sino cómo llegaron ahí.
3. Deja que los agentes reporten sin tener que perseguirlos
Los agentes escriben sus propios check-ins en los key results y publican actualizaciones en las iniciativas, incluido un estado de trabajo como en progreso, en revisión, bloqueado o hecho. Cada elemento está marcado con el avatar del agente y la persona que lo configuró, así siempre sabes qué escribió un humano y qué escribió un agente.
Tability también se asegura de que las actualizaciones de los agentes sigan siendo útiles. Un agente puede publicar un nuevo check-in por key result cada día, y las actualizaciones se mantienen lo bastante cortas para leerse fácilmente. «On track» no te dice nada. Una buena actualización de agente dice qué se movió, por qué se movió, qué está bloqueado y qué pasa después, con una calificación de confianza encima. Cuando algo está bloqueado, el agente lo señala y dice qué necesita.
Nuestro propio agente de contenido trabaja así. En cada ejecución, reporta cuántas piezas están terminadas, cuáles pasaron a revisión, qué eligió hacer a continuación y por qué, y si el objetivo está en verde, amarillo o rojo. Escribimos sobre la diferencia en cómo los Agentes de Tability escriben sus informes de estado.
4. Revisa el rendimiento de toda la flota
Una vez que varios agentes están reportando, la pregunta cambia de «¿se ejecutó?» a «¿quién está entregando, y quién necesita atención?». La página de Agentes responde eso. Su vista «Trabajo entregado» cubre los últimos 7 o 30 días y cuenta tareas completadas, check-ins publicados, key results que se movieron y cambios de confianza, con una comparación respecto al período anterior. También muestra cuántos de tus agentes estuvieron activos.
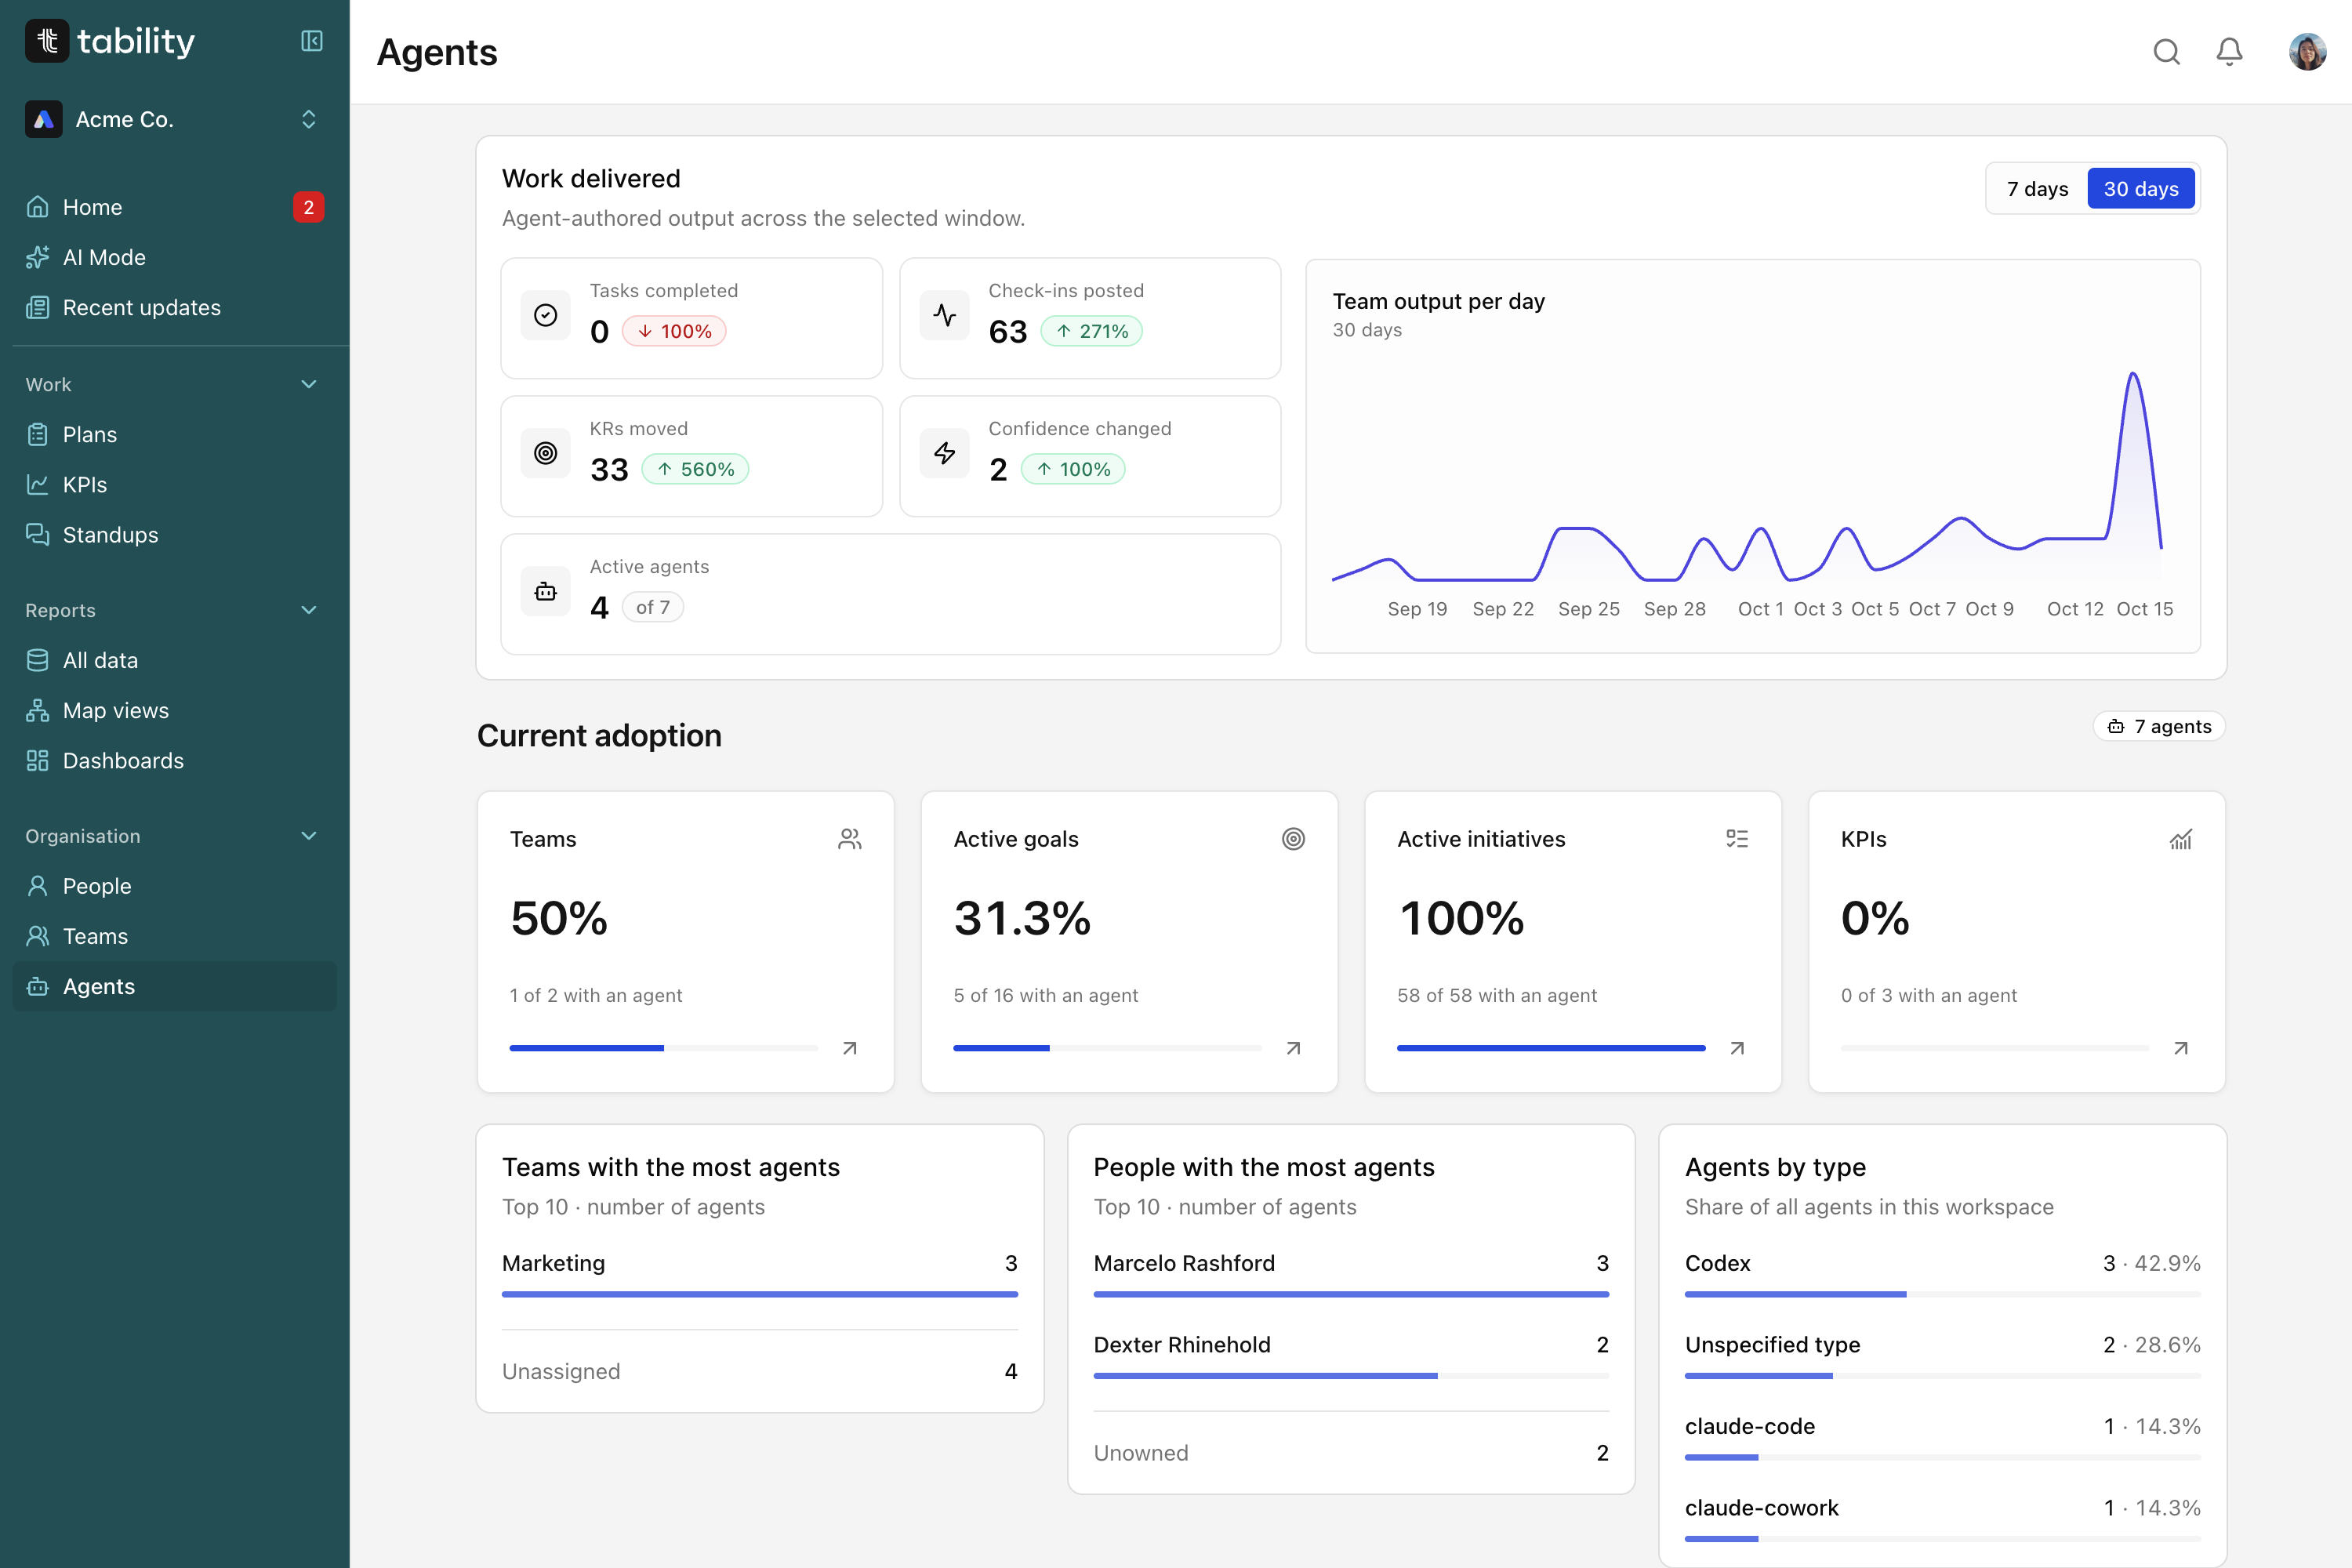
Debajo, una tabla lista cada agente con su responsable, progreso de KR, tareas, output reciente y última actividad. Puedes ordenar por más activo, progreso o necesita atención, y filtrar por agentes activos, inactivos o que necesitan atención. «Necesita atención» significa más key results rojos que verdes. «Inactivo» significa sin output en la ventana. Cuando un objetivo se cierra o un agente deja de mover nada, esa es tu señal para retirarlo o apuntarlo hacia algo nuevo. Esa es la decisión de «retirarlo» que la mayoría de las flotas nunca llegan a tomar.
Si además necesitas reportar todo esto hacia arriba, nuestra guía sobre cómo medir el rendimiento de la IA en el trabajo explica cómo presentar actividad, coste y resultados a tu manager.
5. Dirige con comentarios
Cuando un agente necesita dirección, comenta su check-in o responde a su actualización de iniciativa, igual que harías con un compañero. El agente lee ese feedback la próxima vez que se ejecuta, y se ajusta. No responderá al instante, porque Tability no ejecuta tus agentes por ti. Los horarios y la ejecución se quedan en tu asistente, que es también donde controlas con qué frecuencia reporta un agente.
Dónde encaja Tability (y dónde no)
Para que quede claro, Tability no es una herramienta de tracing. No te mostrará trazas a nivel de token ni te dirá por qué falló una llamada a una herramienta, y tampoco programa ni ejecuta agentes, así que mantén tu plataforma de observabilidad y tu asistente para esas tareas. Lo que añade es la capa que ellas se saltan: un objetivo, un responsable, un registro de lo que reportó el agente y una forma de que el equipo lo dirija, todo en un solo lugar que todos pueden ver. Es la misma división que los equipos de StratOps ya usan para el trabajo humano, y la orquestación de agentes explica cómo varios agentes se coordinan hacia un mismo objetivo.
Si quieres verlo con tus propios agentes, la página de agentes de IA de Tability es el recorrido más rápido.
Errores comunes en el monitoreo de agentes de IA
- Monitorear tokens en lugar de resultados. El coste por ejecución es útil. El coste por resultado es lo que realmente quieres, y te mostramos cómo medir el rendimiento de la IA en el trabajo de una forma en la que tu manager confiará.
- Sin responsable nombrado. Una alerta sin dueño es una notificación que nadie lee.
- Alertar sobre todo. Si cada ejecución le avisa a alguien, acabará silenciando el canal. Alerta sobre las excepciones y revisa el resto con una frecuencia fija.
- No retirar nunca un agente. Los agentes son fáciles de crear e incómodos de apagar. El monitoreo debería hacer que «retirarlo» sea una decisión normal.
- Tratarlo como una configuración de una sola vez. Los objetivos cambian. Revisa con regularidad que cada agente siga apuntando a uno que todavía exista.
Dónde te deja esto
Volviendo a ese dashboard en verde. No estaba equivocado, solo estaba respondiendo a la pregunta equivocada. El monitoreo de salud y comportamiento te dice si tus agentes funcionan. El monitoreo de resultados te dice si el trabajo importa, y esa es la parte que decide qué agentes se quedan en la nómina.
Si estás ejecutando más de un par de agentes y quieres que rindan cuentas ante objetivos reales, Tability es un punto de partida sencillo. Regístrate gratis, mira cómo funcionan los Agentes de Tability, o reserva 30 minutos con nosotros y te ayudaremos a averiguar cómo debería verse el monitoreo para tu flota. Con Tability o sin él, dale a cada agente un objetivo y un responsable.