Frag gerade fünf Leute, die mit Agenten bauen, was Agent-Orchestrierung bedeutet, und du bekommst fünf verschiedene Antworten. Für den einen ist es LangGraph oder CrewAI, das eine Aufgabe zwischen Modellen weiterleitet. Für den anderen ist es ein „Manager“-Agent, der Arbeit an Spezialisten verteilt. Für wieder jemand anderen ist es eine Governance-Schicht, die kaum etwas mit Agenten zu tun hat.
Ein r/AI_Agents-Thread hat dem Frust einen Namen gegeben:
Bin ich der Einzige, den es nervt, dass „Orchestrierung“ inzwischen buchstäblich alles in der KI bedeutet?
Das Argument: Anbieter verwenden das Wort für mindestens drei verschiedene Ebenen, Agentenkoordination, Workflow-Routing und Governance, und nach 27 Kommentaren hatte sich niemand darauf geeinigt, wo die eine endet und die nächste beginnt.
Die Verwirrung dreht sich aber eigentlich nicht um Semantik. Von „Orchestrierung“ wird verlangt, zwei wirklich unterschiedliche Aufgaben zu beschreiben, und das meiste, was unter diesem Namen vermarktet wird, erledigt nur eine davon.
Aufgabe eins ist Routing. Aufgabe zwei ist Verantwortung.
Aufgabe eins ist technisch: Bei einer gegebenen Aufgabe entscheiden, welches Modell oder Tool welchen Schritt übernimmt, Kontext weitergeben, bei Fehlern erneut versuchen. Genau das tun die meisten Orchestrierungs-Frameworks, LangGraph, CrewAI, maßgeschneiderte Pipelines, tatsächlich, und das ist ein einigermaßen gelöstes Problem.
Aufgabe zwei ist ein Management-Problem, kein Routing-Problem: Wer verantwortet, ob sich ein Ziel tatsächlich bewegt, welche Agenten existieren und warum, und was passiert, wenn einer von ihnen sich nicht mehr lohnt. Fast nichts, was als „Orchestrierung“ vermarktet wird, erledigt diese Aufgabe. Ein populärer Thread im selben Subreddit hat diese Lücke unverblümt benannt und argumentiert, dass viele Multi-Agent-Stacks Manager- und Reviewer-Rollen hinzufügen, die nie an etwas Realem gemessen werden, ein Organigramm ohne jede Nachverfolgbarkeit von Verantwortung dahinter. Was auch immer du von dieser Kritik hältst, sie zeigt auf dasselbe Loch: Ein Router ist keine Management-Ebene, und ihn so zu nennen macht ihn nicht dazu.
Selbst die strengeren Einordnungen der Branche bleiben davor stehen. Das Inner-Loop/Outer-Loop-Modell eines Anbieters für Enterprise-Workload-Automatisierung teilt Agentenarbeit in eine Ausführungsebene (Reasoning, Tool-Aufrufe) und eine Governance-Ebene (Status, Wiederholungen, Freigaben) auf, und weiter geht es nicht: eine Ausführungsebene und eine Prozess-Governance-Ebene, nie eine, die fragt, wer für das Ziel verantwortlich ist.
Der eigentliche Engpass ist nicht Routing, sondern Supervision
Diese Lücke zeigt sich als sehr konkretes, praktisches Problem, sobald Teams über einen einzigen Agenten hinauswachsen. Ein r/AI_Agents-Thread genau zu diesem Thema stellte fest, dass ein einzelner Coding-Agent überschaubar zu betreiben ist, dass aber die Supervision mehrerer gleichzeitig laufender Agenten schnell zum eigentlichen Engpass wird, nicht das Routing zwischen ihnen, sondern schlicht die Last, herauszufinden, was einer von ihnen falsch macht. Eine Person brachte es noch deutlicher auf den Punkt, als sie nach „Orchestrierungs-/Chief-of-Staff“-Tools suchte, um ihre Agenten und Projekte organisiert zu halten: Was sie eigentlich suchte, war kein Router, sondern etwas, das die Koordinationsarbeit übernimmt, die sie sonst von Hand erledigen musste.
Das ist das Problem, das Aufgabe zwei lösen muss. Eine Ebene, die nur Nachrichten zwischen Modellen weiterleitet, rührt das nicht an. Was wirklich hilft, ist etwas, das die Supervisionslast von einer Person nimmt, nicht nur die Übergabelogik von einem Modell.
Was Agent-Orchestrierung bei Tability bedeutet
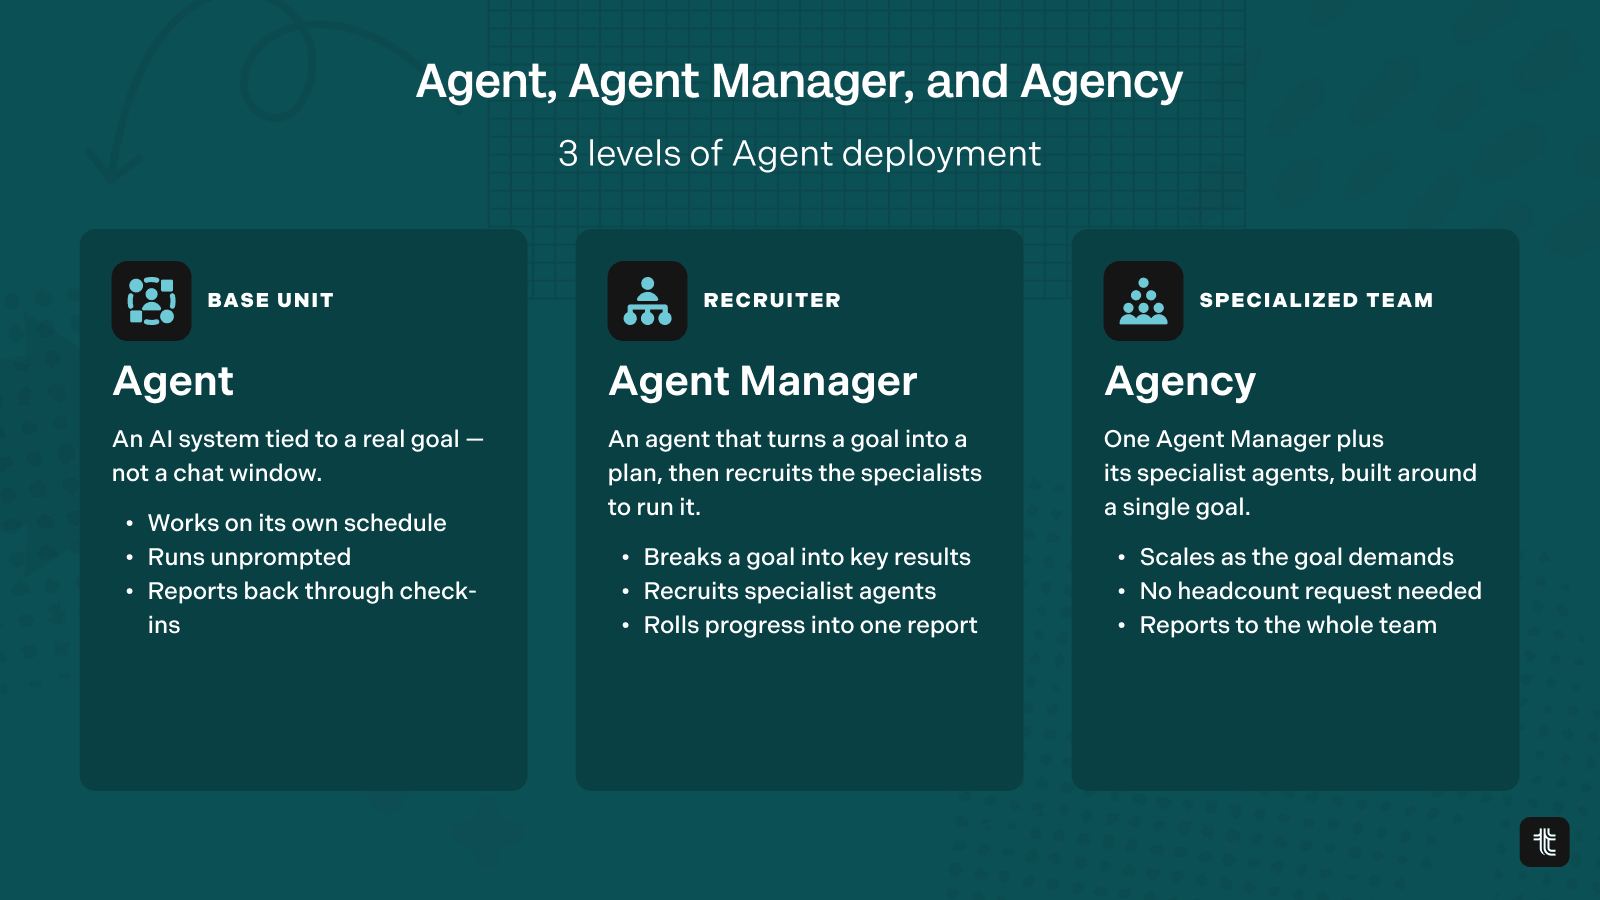
Genau dafür ist der Agent Manager von Tability gebaut. Es gibt keine feste Liste von Agenten, die auf ihre Zuweisung warten. Du startest mit einem Ziel, einer Metrik, einem Ausgangswert, einem Termin, in derselben Form wie ein Key Result in einem OKR-Framework, nicht als To-do-Eintrag. Ein Agent Manager übernimmt die Verantwortung für dieses Ziel, zerlegt es in einen Plan und ermittelt erst dann, welche Spezialisten der Plan tatsächlich braucht. Tability nennt die entstehende Einheit eine Agency: ein Manager plus das Team, das sein eigener Plan verlangt hat, derzeit auf insgesamt sechs begrenzt, während das System lernt, wo die Koordination mit einer größeren Crew zu bröckeln beginnt.
„Tability fungiert als die Business-Context- und Orchestrierungsebene“, wie es das Team bei der Beschreibung seines eigenen Setups selbstrekrutierender Agententeams formuliert hat, und genau das ist der Unterschied, der hier zählt. Es geht nicht darum, zu entscheiden, welches Modell welchen Schritt übernimmt. Es ist die Ebene, die das Ziel, den Plan und die Aufzeichnung darüber trägt, ob sich tatsächlich etwas bewegt hat, genau die Aufgabe, für die Routing-Frameworks nie gebaut wurden.
Es ist auch dieselbe operative Disziplin, die StratOps bereits auf menschliche Teams anwendet, ein Owner, ein Rhythmus, eine sichtbare Aufzeichnung des Fortschritts gegenüber einer echten Zahl, nur erweitert auf Agenten, die für ein Ziel rekrutiert statt für eine Rolle eingestellt wurden.
Aufgabe zwei wird schon jetzt von Hand gebaut
Das ist kein hypothetisches Bedürfnis. Ein r/AI_Agents-Thread, der fragte, ob schon jemand ein Muster aus „Manager-Agent weist Spezialisten-Agenten Arbeit zu“ ausprobiert hat, bekam Dutzende Antworten von Leuten, die genau das schon tun, mit gemischten Ergebnissen. Eine Person beschrieb, wie sie einem Agenten ein Spec gab, ihn die Arbeit in Module zerlegen ließ und dann für jedes Modul separate Coding-, Test- und Review-Agenten generierte und laufen ließ, wodurch ein Projekt, das sechs Wochen zu je 40 Stunden gedauert hätte, auf etwa zehn Stunden beaufsichtigter Arbeit schrumpfte. Andere warnten, dass dasselbe Muster genauso leicht eine „absurde Architektur“ voller Agenten hervorbringen kann, die das tun, was ein einziger gut ausgestatteter Agent oder ein simples deterministisches Skript schneller und billiger hätte erledigen können.
Beides stimmt, und genau das ist der Punkt. Das Muster Manager-plus-Spezialisten ist real und funktioniert, aber ob sich der Mehraufwand in einem konkreten Fall lohnt, hängt vollständig davon ab, ob es in einem echten Ziel verankert ist oder zusammengestellt wurde, weil es nach der Art von Setup aussah, das ein „richtiges“ System haben sollte. Genau diese Einschätzung trifft der Agent Manager strukturell, indem er das Team aus dem Plan ableitet, statt es demjenigen zu überlassen, der in der jeweiligen Woche gerade Threads von Hand zusammenbaut.
| Dimension | Ad-hoc-Multi-Agent-Setup | Tability Agent Manager |
|---|---|---|
| Wie das Team entschieden wird | Von Hand zusammengestellt, Thread für Thread, bevor die Arbeit beginnt | Aus dem Plan abgeleitet, sobald das Ziel feststeht |
| Wer für das Ziel verantwortlich ist | Meist niemand Bestimmtes | Der Agent Manager, für dieses Ziel |
| Was passiert, wenn ein Agent nichts beiträgt | Läuft weiter, es sei denn, jemand bemerkt es zufällig | Wird im nächsten Zyklus nicht wieder rekrutiert |
| Wo die Supervisionslast liegt | Bei einer Person, und sie wächst mit jedem hinzugefügten Agenten | Von der Ebene selbst getragen, Check-ins und Berichte |
| Woran du erkennst, dass es funktioniert | Gar nicht, ohne die Logs zu lesen | An der eigenen Metrik des Ziels |
Die Teamgröße ist nicht die interessante Variable. Wer dafür verantwortlich ist, schon.
Wie das in der Praxis aussieht
In einem aktuellen Build wurde ein einzelnes Ziel, den Traffic-Wert von 15.000 $ auf 20.000 $ zu steigern, an einen Agent Manager übergeben. Achte darauf, was nicht passiert ist: Niemand hat im Voraus entschieden, dass das Team eine SEO-Person, einen Repair-Spezialisten und einen PR-Spezialisten braucht. Der Manager hat das Ziel zuerst in einen Plan zerlegt, und der Plan hat genau diese drei Rollen hervorgebracht, in dieser Kombination, spezifisch für dieses Ziel. Ein anderes Ziel hätte ein anderes Team rekrutiert. Vom Setup bis zu einem arbeitsfähigen Team dauerte es etwa zwei Minuten, ohne die Denkzeit dazwischen mitzurechnen, und Tability hat das Ganze als Speedrun des Setups veröffentlicht.
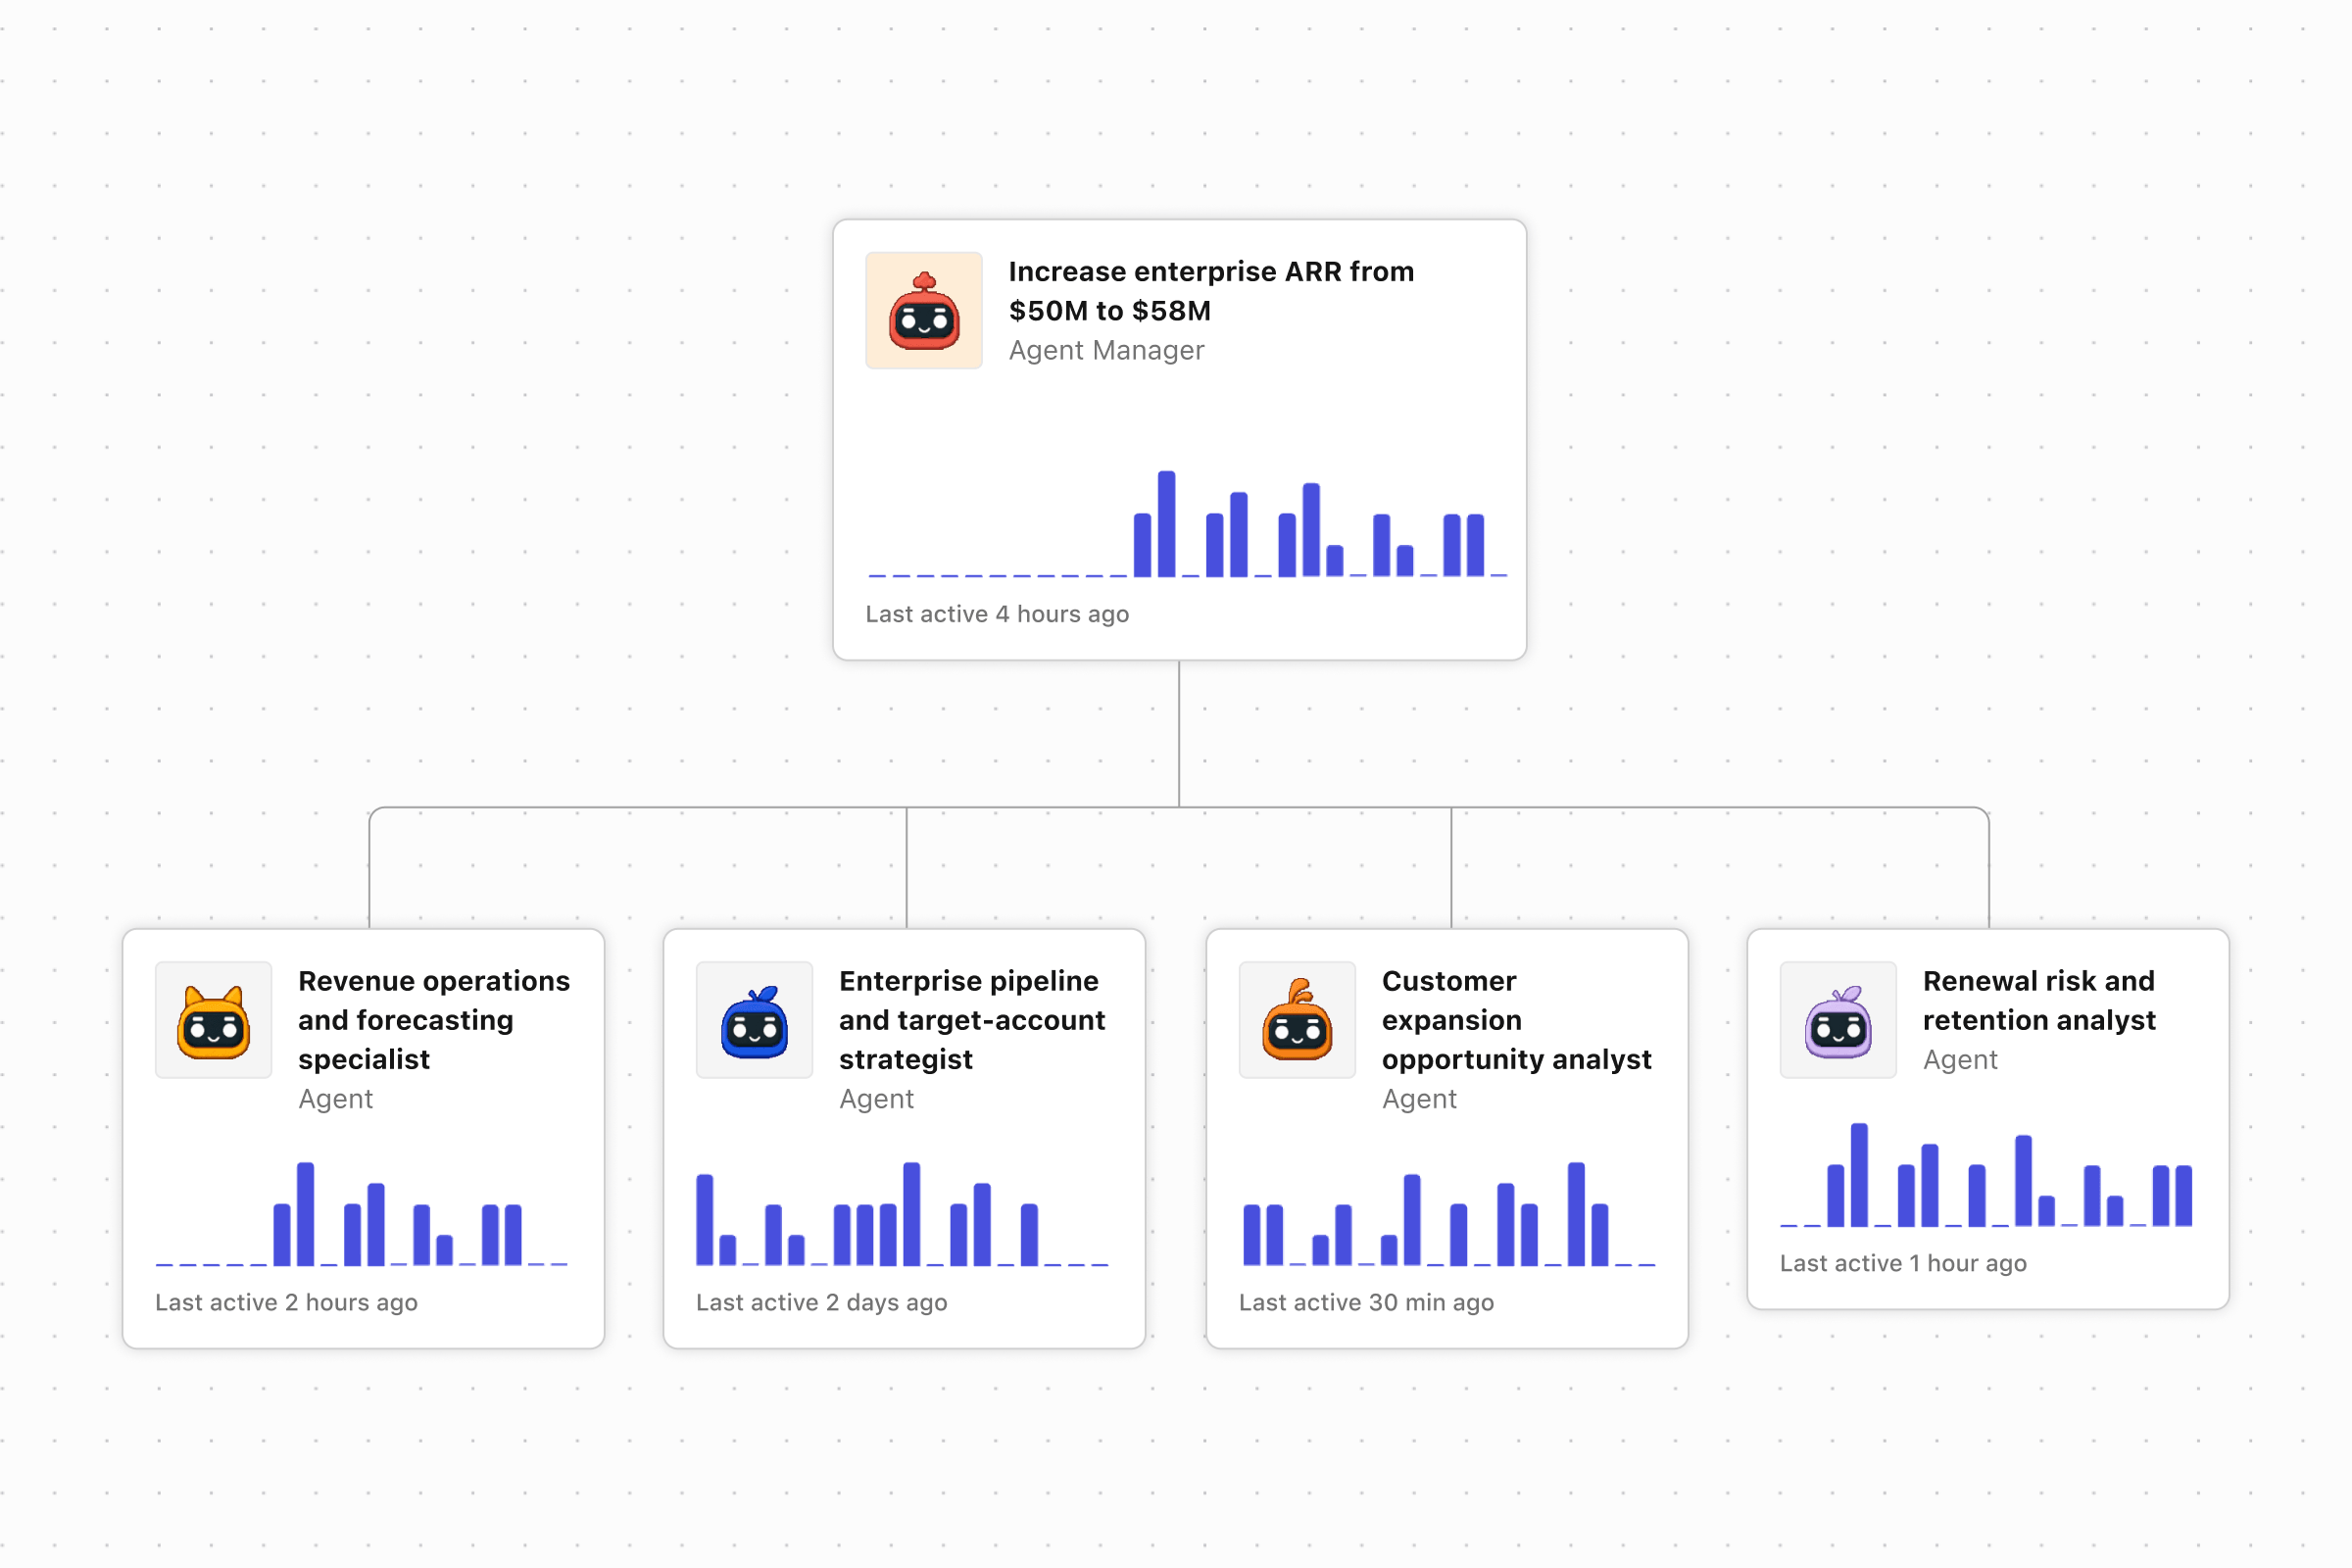
Zoom heraus, und die Zahlen werden interessanter, und zurückhaltender, als man es von einem System erwarten würde, das Agenten skalieren soll. Ein früherer Build von Tabilitys selbstrekrutierendem Agentensystem wuchs von nur vier Managern auf 20 Agenten, mit der erklärten Absicht, über 100 hinaus weiter zu skalieren. Aber die Teamgröße pro Agency liegt derzeit bei sechs (ein Manager plus fünf Spezialisten), eine bewusste Obergrenze, während das Team lernt, wo die Koordination mit einer größeren Crew zu bröckeln beginnt. Selbst innerhalb eines Systems, das genau dafür gebaut wurde, ist unbegrenzter Fan-out nicht das Ziel. Ein Team, das nur wächst, wenn der Plan tatsächlich mehr Hände verlangt, ist es.
Der Engpass war, nach eigener Aussage des Teams, nie, die Agenten zur Arbeit zu bringen. Es war, mit dem mitzuhalten, was zurückkam: Berichte, Vorschläge, Fragen, Updates. Das ist dieselbe Supervisionslast, die der Multi-Agent-Thread oben beschrieben hat, und es ist auf seltsame Weise ein gutes Zeichen: Es bedeutet, dass die Agenten genug echte Arbeit leisteten, um echte Dinge zum Überprüfen zu erzeugen, nicht nur Status-Updates übereinander.
Das Team vor dem Ziel aufzustellen, ist der übliche Fehler
Der Instinkt, wenn Agenten anfangen zu arbeiten, ist, zuerst das Team zu skizzieren. Ein Orchestrator hier, ein Reviewer dort, ein Spezialist für jede Funktion, die dir einfällt, im Voraus entschieden, bevor auch nur eine einzige reale Aufgabe existiert, die einen davon rechtfertigt.
Die Lösung ist keine bessere Prompt-Bibliothek für diese Rollen. Sie besteht darin, das Team vorab gar nicht erst zu entwerfen. Du weist das Ziel zu, lässt den Plan genau offenlegen, was er braucht, und behandelst die fortgesetzte Existenz jedes Agenten als etwas, das sich jeden Zyklus neu verdienen muss, nicht als etwas, das einmal beim Setup gewährt wird.
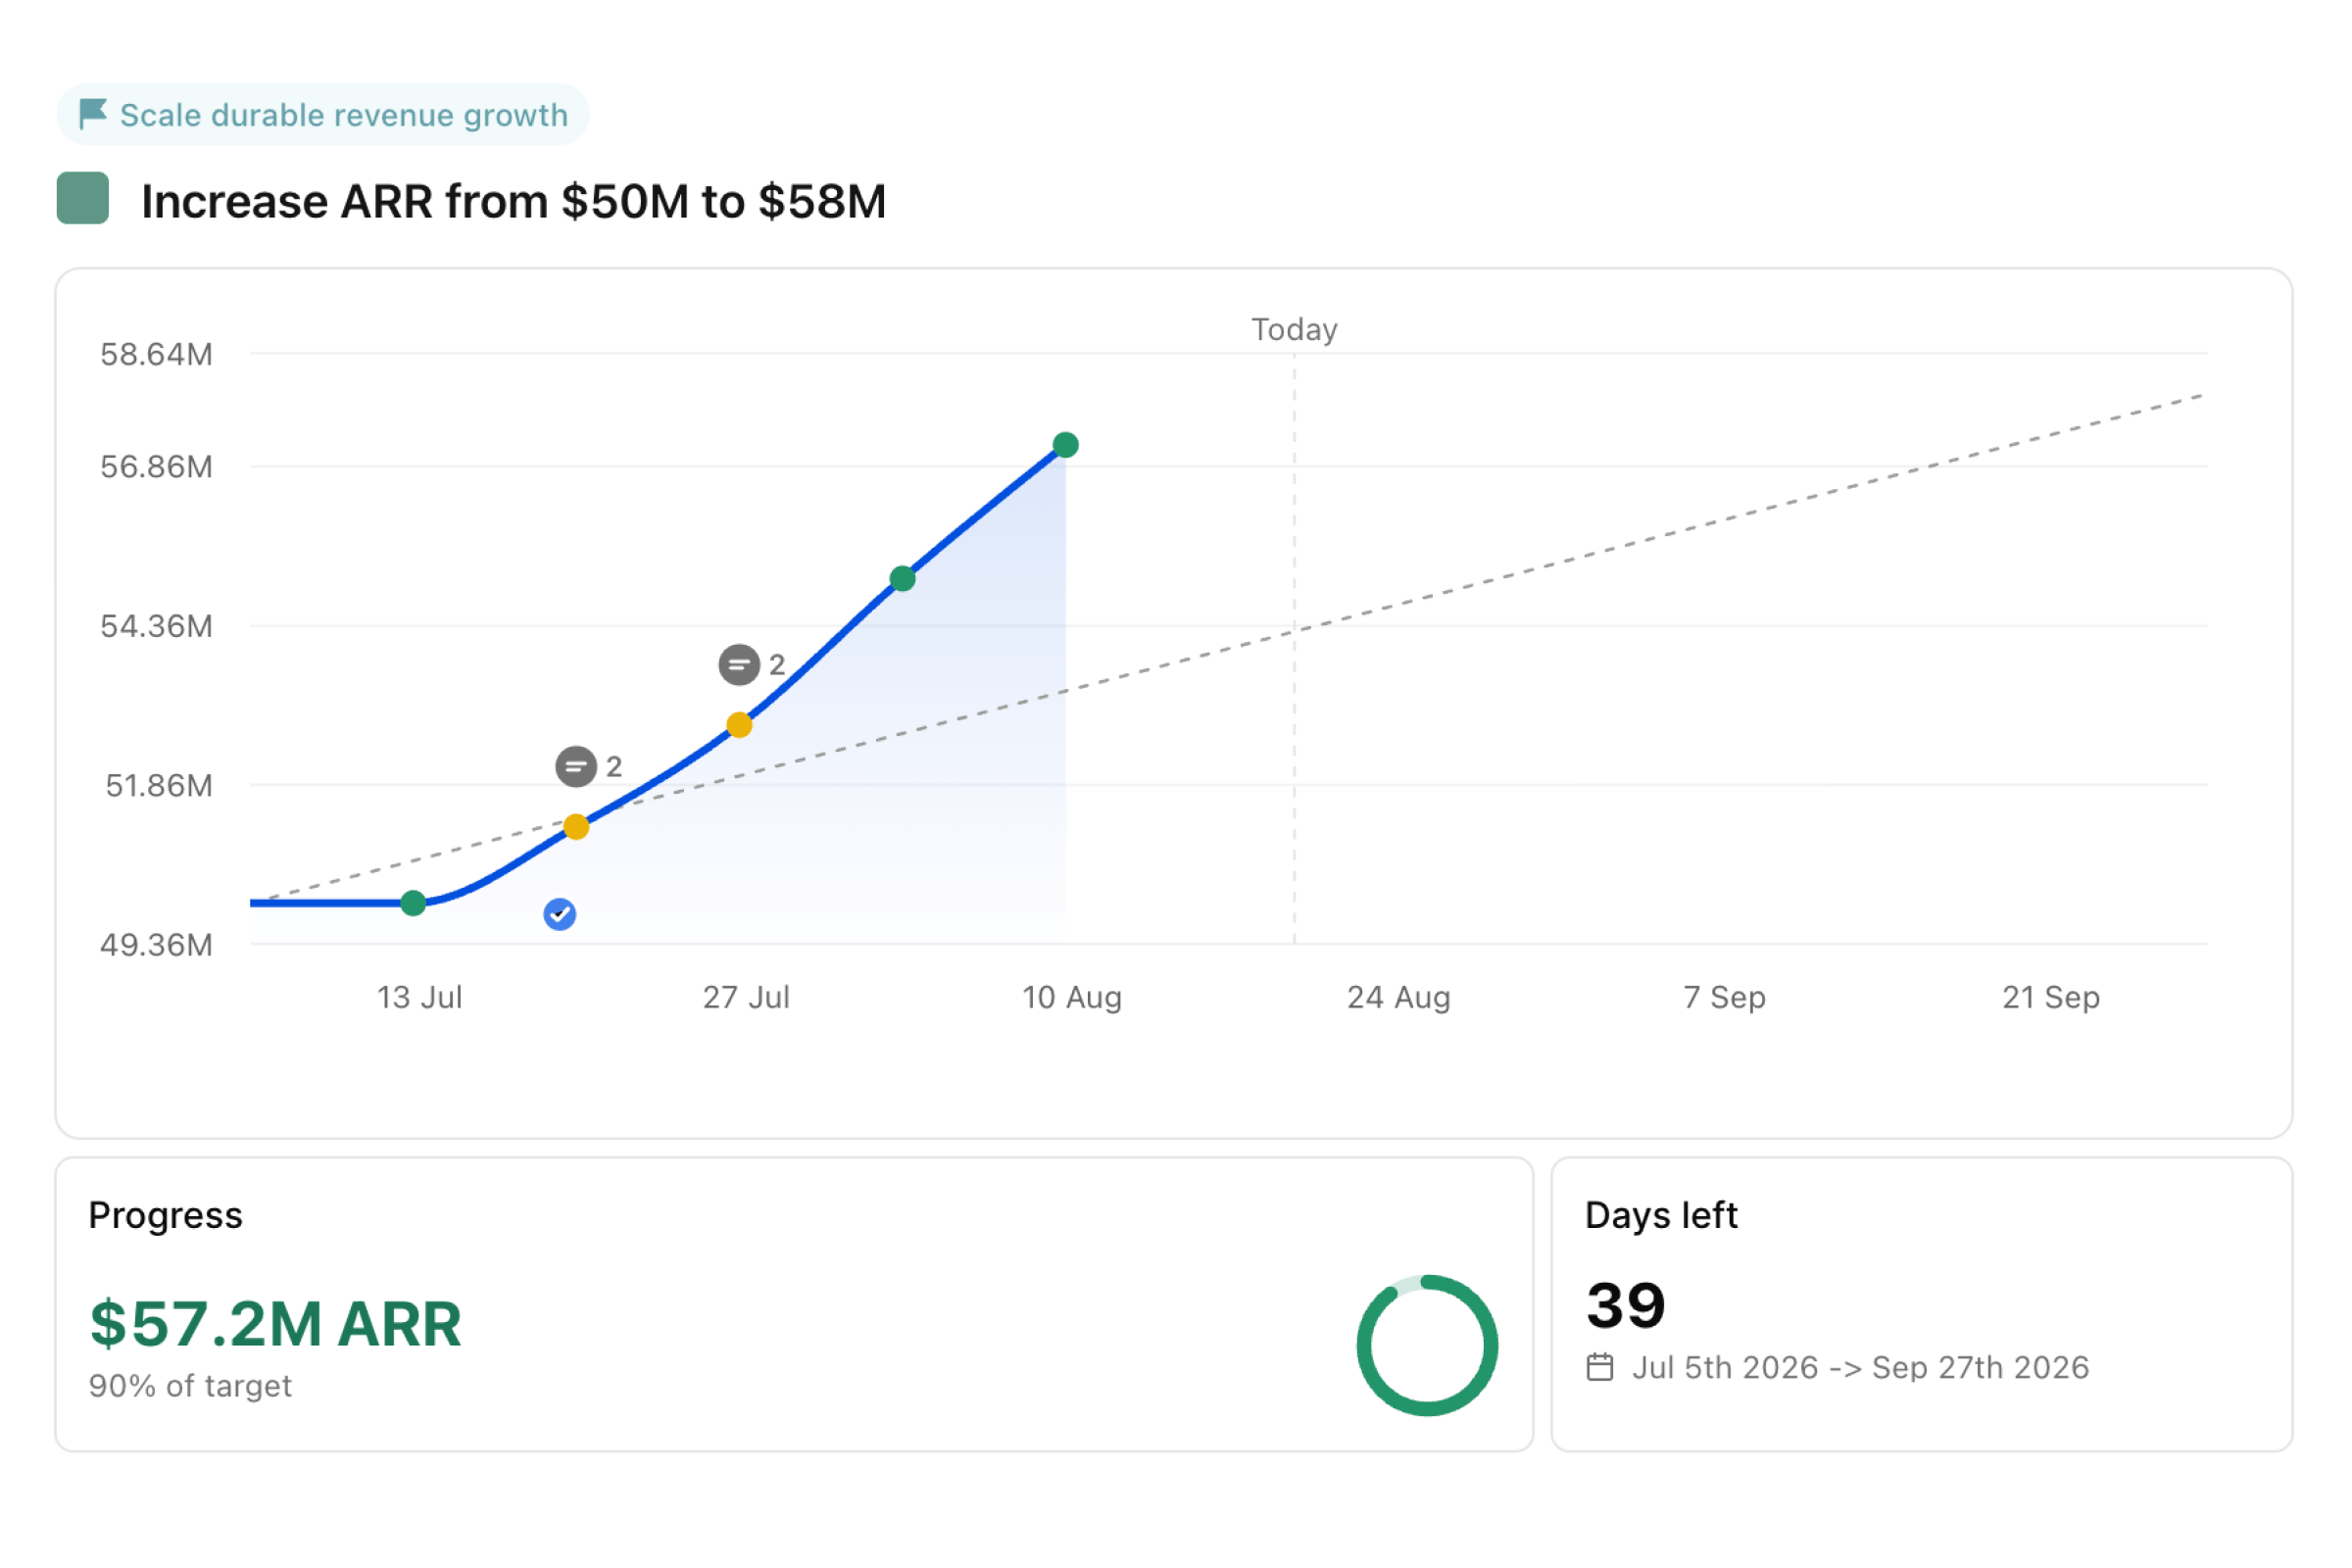
Hier scheitern auch die meisten selbstgebauten Orchestrierungs-Setups still und leise: nicht am technischen Routing, sondern an der Verantwortlichkeit. Kein Ziel, an das ein bestimmter Agent tatsächlich gebunden ist, kein fester Rhythmus, um zu prüfen, ob er etwas bewegt hat, kein einziger Ort, an dem ein Teammitglied nachsehen kann, was real ist und was nur läuft. Am Ende hast du jede Menge Output und einen wachsenden Supervisionsjob, für den sich niemand gemeldet hat.
Wo du anfangen solltest
Bevor du den nächsten Agenten zu deinem Setup hinzufügst, sind drei Fragen nützlicher als jeder Framework-Vergleich:
- Gibt es einen einzigen Ort, an dem du nachsehen könntest, ob die Arbeit dieses Agenten das Ziel bewegt hat, ohne ein Chat-Log zu lesen?
- Wenn du ihn entfernen würdest, müsste dann eine Person die Supervisionslücke übernehmen, oder würde sich eigentlich nichts ändern?
- Wurde er rekrutiert, weil der Plan es verlangte, oder weil es nach der Art von Rolle aussah, die ein Team wie dieses angeblich haben sollte?
Wenn du bereits Agenten über Claude oder Codex laufen lässt, verschwindet nichts von dieser Infrastruktur. Tability ersetzt weder deine Modelle noch deine Tools. Es sitzt darüber, als die Ebene, die das Ziel, den Plan und die Aufzeichnung darüber trägt, ob tatsächlich etwas passiert ist, damit du diese drei Fragen beantworten kannst, ohne dich durch ein Chat-Log zu wühlen.
Probiere Tability kostenlos aus, oder buch 30 Minuten mit uns, und wir schauen uns dein tatsächliches Setup an, Agent für Agent, und helfen dir herauszufinden, wer wofür wirklich verantwortlich ist. Ob mit oder ohne Tability, es lohnt sich, die Antwort zu kennen.