Jedes Unternehmen hat inzwischen einen KI-Agenten-Piloten durchgeführt. Die meisten davon liegen still in einer Präsentation mit dem Titel „Phase zwei“. Die Demo hat einwandfrei funktioniert. Der Agent hat Fragen beantwortet, ein Dokument entworfen, vielleicht sogar ein Meeting gebucht. Dann hat jemand die Frage gestellt, die wirklich zählt: Wer ist verantwortlich, wenn etwas schiefgeht, und woher würden wir das wissen? Niemand hatte eine gute Antwort, also blieb der Pilot ein Pilot.
Das ist kein Technologieproblem. Die Modelle sind gut genug.
Eine MIT-Studie aus 2025 zu KI-Piloten in Unternehmen fand das gleiche Muster in großem Maßstab: 95 % tauchen nie in der Gewinn-und-Verlust-Rechnung auf, und die Lücke liegt daran, wie die Organisation das Tool aufnimmt, nicht am zugrunde liegenden Modell. Es ist ein Governance- und Verantwortungsproblem, und es zeigt sich in dem Moment, in dem ein KI-Agent von „einer coolen Demo fürs Innovationsteam“ zu „etwas, das Umsatz, Kunden oder Personalentscheidungen berührt“ wechselt.
Unternehmen brauchen eigentlich keine Agenten, die überzeugend chatten können. Sie brauchen Agenten, die ein Ergebnis verantworten, ehrlich darüber berichten und zur Rechenschaft gezogen werden können, wenn sie abdriften, denselben Maßstab, der für jeden Mitarbeiter gilt.
Das unterscheidet einen echten Enterprise-KI-Agenten von einem Consumer-Chatbot im Agenten-Kostüm, und genau das lassen die meisten Anbieter, die „Enterprise-KI-Agenten“ verkaufen, still unter den Tisch fallen.
Was macht einen Agenten überhaupt zu „Enterprise“
Für eine einzelne Person, die experimentiert, kann ein KI-Agent einfach ein Chat-Assistent sein, der auf Aufforderung ein paar Aktionen ausführt. Das ist in diesem Maßstab völlig in Ordnung. Sobald mehr als ein Team oder mehr als ein Budget im Spiel ist, tauchen drei neue Anforderungen auf, die nichts mit der Modellqualität zu tun haben:
- Jemand ist verantwortlich für das, wozu sich der Agent verpflichtet. Nicht der Anbieter, nicht „das KI-Team“. Ein benannter Owner, genauso wie ein Projekt einen Lead hat.
- Es gibt eine Audit-Spur davon, was er getan hat und warum. Wenn ein Agent eine E-Mail verschickt, einen Datensatz ändert oder eine Empfehlung ausspricht, kannst du im Nachhinein die Begründung sehen, nicht nur das Ergebnis.
- Er ist in die Art und Weise eingebunden, wie das Unternehmen bereits Fortschritt, Ziele, Initiativen, OKRs, verfolgt, statt als Schattensystem zu laufen, das außerhalb des Pilotteams niemand sieht.
Die Enterprise-KI-Agenten, die über die Pilotphase hinaus überleben, sind die, die von Tag eins an um diese drei Anforderungen herum gebaut wurden. Die, die diese Latte nicht reißen, funktionieren in der Demo meist wunderbar und werden dann sechs Wochen später still nicht mehr genutzt, nicht weil sie versagt haben, sondern weil niemand sagen konnte, wer für sie verantwortlich war.
Warum die meisten Agenten-Plattformen diese Latte nicht reißen
Zwei Muster tauchen immer wieder auf, wenn Unternehmen KI-Agenten-Plattformen bewerten, und beide verfehlen das Verantwortungsproblem auf unterschiedliche Weise.
Das erste ist die Developer-Framework-Route: LangGraph, CrewAI, oder ein eigener Stack auf Basis einer LLM-API.
Diese sind wirklich mächtig und geben Engineering-Teams volle Kontrolle darüber, was ein Agent tun kann. Aber Kontrolle ist nicht dasselbe wie Verantwortlichkeit. Nichts in diesen Frameworks bringt von Haus aus ein Konzept mit für „wer besitzt das Ziel dieses Agenten“ oder „wie steht es um seinen Fortschritt“. Dein Engineering-Team muss diese Schicht selbst bauen, zusätzlich zu allem anderen, was es sowieso schon baut, und die meisten kommen nie dazu.
Das zweite ist der chat-verpackte Assistent: ein wirklich nützliches Tool, das Fragen beantwortet und ein paar Aktionen ausführt, aber nur, wenn jemand ihn dazu auffordert.
Er hat keinen Platz im Organigramm, arbeitet nicht nach eigenem Zeitplan und ist nicht für ein Ergebnis verantwortlich, so wie es eine Person oder ein richtig eingesetzter Agent wäre. Marketing nennt es einen Agenten. Es ist ein Assistent, und daran ist nichts falsch, außer wenn er als Antwort auf ein Governance-Problem verkauft wird, das er nie lösen sollte.
Gartner hat einen Namen für dieses zweite Muster: Agent Washing, das Umetikettieren bestehender Chatbots und Automatisierungstools als Agenten, ohne dass darunter echte agentische Fähigkeiten stecken. Gartner schätzt, dass von den Tausenden Anbietern, die sich als agentisch bezeichnen, nur rund 130 es tatsächlich sind, und sagt voraus, dass mehr als 40 % der agentischen KI-Projekte bis Ende 2027 eingestellt werden, genau aus den oben genannten Gründen: explodierende Kosten, unklarer Geschäftswert und nie gebaute Risikokontrollen.
| Developer-Framework (LangGraph, CrewAI) | Chat-verpackter Assistent | Zielverantwortlicher Agent (Tability) | |
|---|---|---|---|
| Handelt ohne Aufforderung | Nur wenn du es selbst baust | Nein, nur Chat | Ja, läuft nach eigenem Zeitplan |
| Hat einen benannten, verantwortlichen Owner | Nein, das ist Infrastruktur | Nein, das ist ein Feature | Ja, ein Agent Manager besitzt das Ziel |
| Berichtet Fortschritt in festem Rhythmus | Nein, das musst du selbst bauen | Nein | Ja, Check-ins sind eingebaut |
| Ist an Ziele geknüpft, die das Unternehmen schon verfolgt | Nein, separates System | Nein, separates System | Ja, nativ zu OKRs und Initiativen |
| Braucht ein Engineering-Team zum Aufsetzen | Ja | Nein, hat aber auch kein Verantwortungsmodell | Nein |
Ein zielverantwortlicher Agent ist der einzige der drei, der alle fünf Hürden ohne Engineering-Aufwand nimmt.
Wie ein zielverantwortlicher Agent in der Praxis aussieht
Die praktische Alternative ist nicht mehr Prompting-Disziplin. Es geht darum, zu ändern, worum herum der Agent gebaut ist. Statt einem Agenten eine Aufgabe zuzuweisen, weist du ihm ein Ziel und einen Platz zu und lässt ihn dann die Spezialisten rekrutieren, die er wirklich braucht.
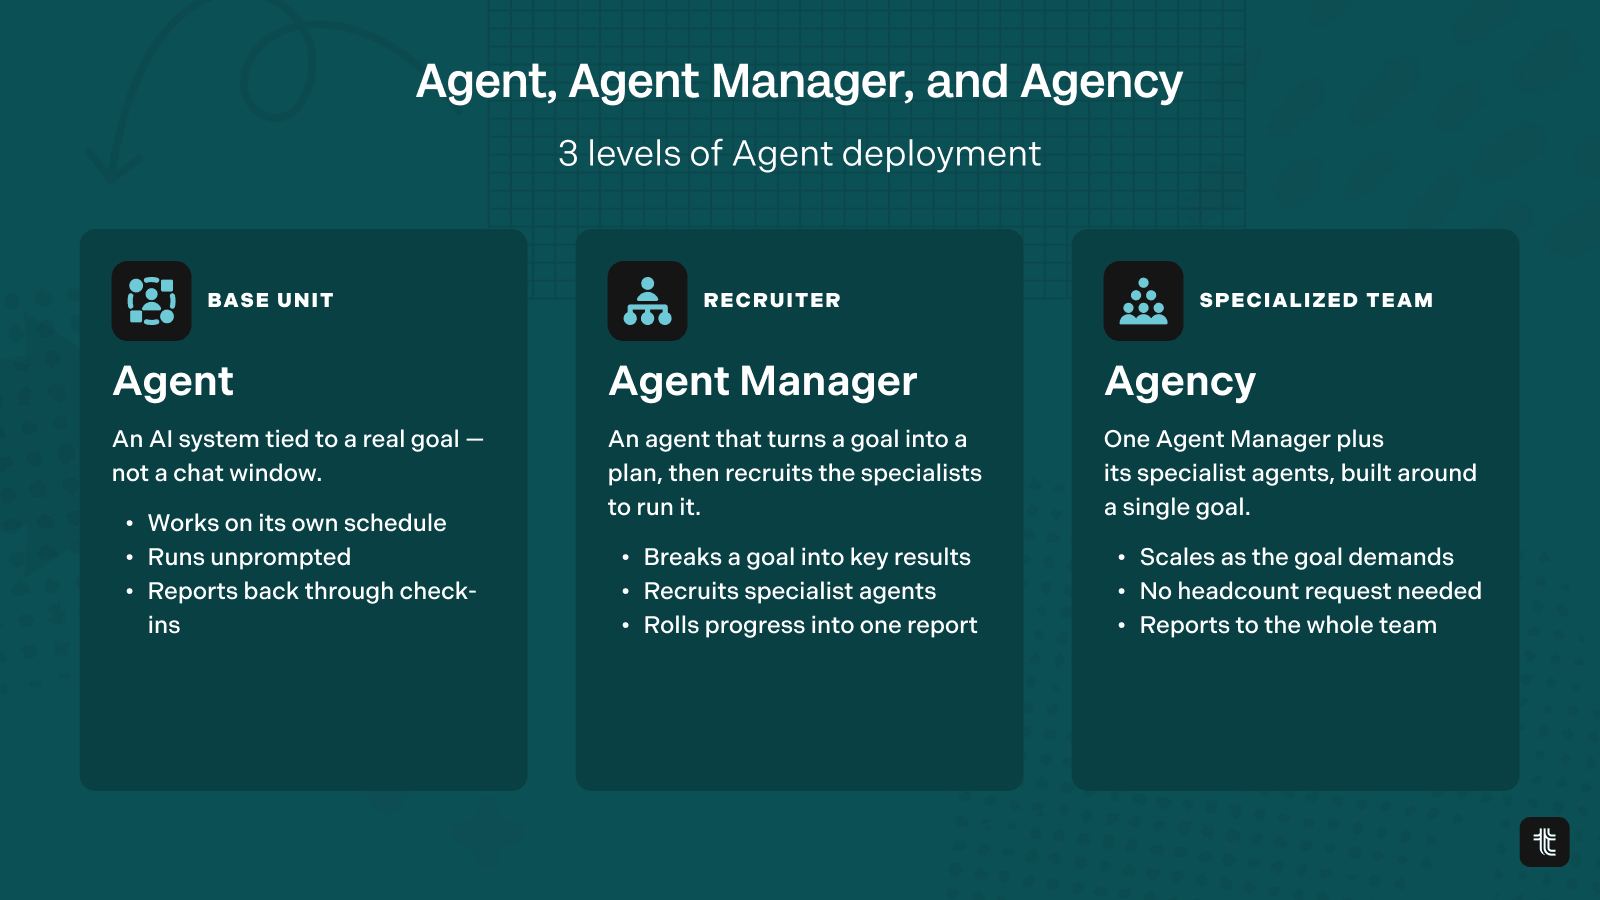
So funktioniert Tabilitys Agent Manager-Modell. Du gibst einem Agent Manager die Verantwortung für ein Ziel, genauso wie du einem neuen Mitarbeiter ein Ziel übergeben würdest. Er zerlegt dieses Ziel in einen Plan, rekrutiert genau die Spezialisten-Agenten, die dieser Plan verlangt (gebaut und ausgeführt in welchem Tool auch immer dein Team schon nutzt: Claude, OpenAI oder andere), und berichtet Fortschritt in festem Rhythmus, statt nur dann, wenn jemand daran denkt zu fragen. Ein Mensch prüft Ergebnisse und Fortschritt, nicht Kopfzahlen, genauso wie ein Manager die Arbeit eines Teams prüft, ohne jede Aufgabe im Detail zu kontrollieren.
Das ist der praktische Unterschied zwischen einem Agenten und einer Agency: Ein einzelner Assistent beantwortet, wonach gefragt wird, während eine Agency, ein zielverantwortlicher Manager plus das Spezialistenteam, das er rekrutiert, weiter am Ziel arbeitet, egal ob jemand zuschaut, und genauso zur Rechenschaft gezogen werden kann wie jeder andere im Team.
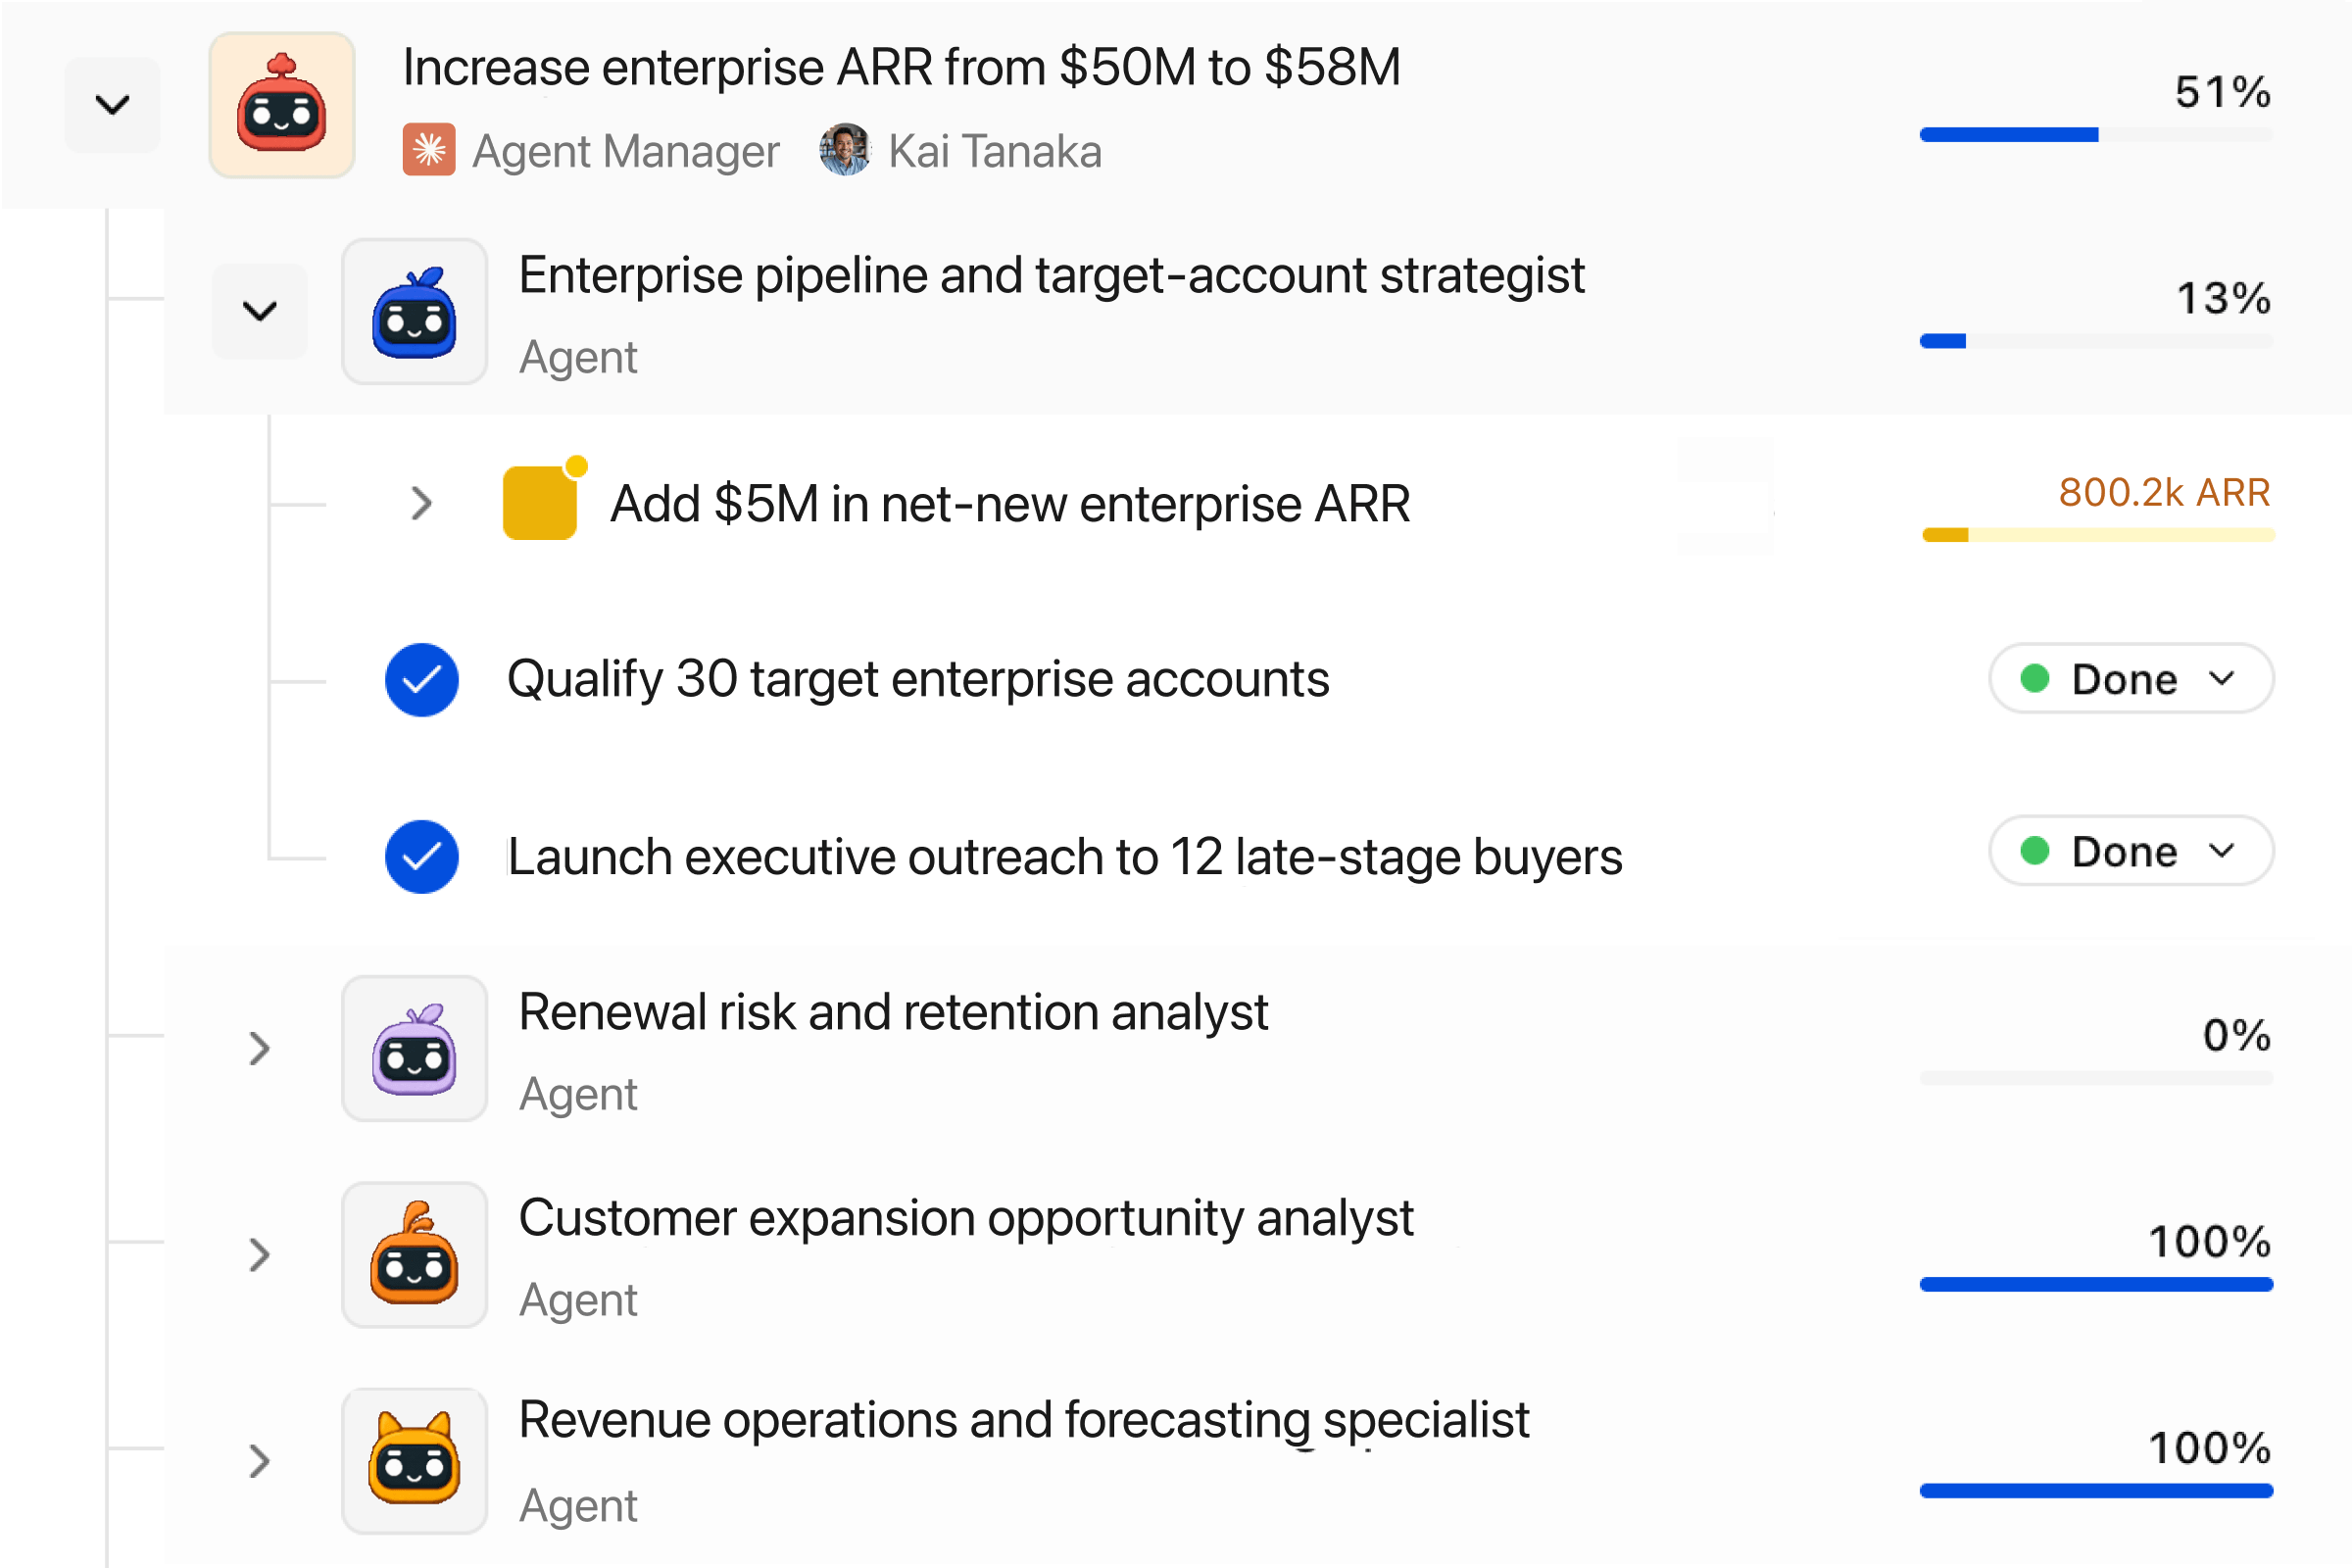
Das ist der praktische Unterschied zwischen einem Agenten und einer Agency: Ein einzelner Assistent beantwortet, wonach gefragt wird, während eine Agency, ein zielverantwortlicher Manager plus das Spezialistenteam, das er rekrutiert, weiter am Ziel arbeitet, egal ob jemand zuschaut, und genauso zur Rechenschaft gezogen werden kann wie jeder andere im Team.
Ein durchgerechnetes Beispiel: ein Enterprise-Ops-Team
Nimm ein Unternehmen mit 400 Mitarbeitenden und einem Q3-Key-Result, die Onboarding-Zeit für Neukunden von 21 auf 10 Tage zu senken. Im Chat-Assistenten-Modell könnte jemand aus dem Ops-Team einen KI-Assistenten bitten, einmal pro Woche die Onboarding-Engpässe zusammenzufassen, die Zusammenfassung lesen und dann manuell entscheiden, was zu tun ist. Nützlich, aber das Denken und die Umsetzung liegen weiterhin vollständig bei einer Person, deren Kalender ohnehin schon voll ist.
Im zielverantwortlichen Modell wird ein Agent Manager direkt auf dieses Key Result angesetzt. Er prüft die Onboarding-Pipeline-Daten in festem Rhythmus, rekrutiert einen Recherche-Agenten, um abgesprungene Testkonten zu befragen, und einen Entwurfs-Agenten, um Prozessverbesserungen vorzuschlagen, und postet jede Woche einen Check-in zum Key Result, egal ob jemand danach fragt. Die Ops-Leitung prüft, was vorgeschlagen wird, und genehmigt oder lenkt es um, genauso wie sie einen Bericht eines direkten Mitarbeiters prüfen würde, nicht so, wie sie ein Chatfenster beaufsichtigen würde.
Der Unterschied liegt nicht darin, wie clever der eine oder andere Ansatz ist. Er liegt darin, dass einer von beiden einen Owner, einen Rhythmus und eine Nachvollziehbarkeit hat, sobald die Führung fragt, wie die Zahl sich entwickelt, und der andere hat nur die Notizen, an die sich jemand erinnert hat.
Eine kurze Checkliste, bevor du über den Piloten hinaus skalierst
Bevor du ein Enterprise-KI-Agenten-Rollout absegnest, schneiden fünf Fragen durch die meisten Anbieter-Pitches:
- Hat er einen benannten Owner, der genauso verantwortlich ist wie eine Person es wäre?
- Berichtet er in festem Rhythmus, nicht nur, wenn jemand daran denkt zu fragen?
- Kannst du sehen, was jeder Agent in der Flotte tut, nicht nur den, den du gerade testest?
- Bindet er sich an die Ziele und Initiativen, die du bereits verfolgst, oder braucht er sein eigenes separates System?
- Würdest du ihm wirklich eine Zahl anvertrauen, an der dein Team gemessen wird, oder nur Fleißarbeit, bei der es niemanden stört, wenn sie falsch läuft?
Wenn die ehrliche Antwort auf mehr als eine dieser Fragen Nein lautet, ist das kein Grund, KI-Agenten aufzugeben. Es ist ein Grund, genauer zu definieren, was „enterprise-ready“ wirklich braucht, bevor der nächste Pilot startet.
Wo Tability ins Bild passt
Tability wurde im OKR Software Benchmark auf Platz 1 für KI-Funktionen eingestuft (4,6/5), vor WorkBoard und Profit.co, größtenteils weil das Agent-Manager-Modell Verantwortlichkeit als erstklassiges Feature behandelt und nicht als nachträglich an eine Chat-Oberfläche angeflanschte Idee.
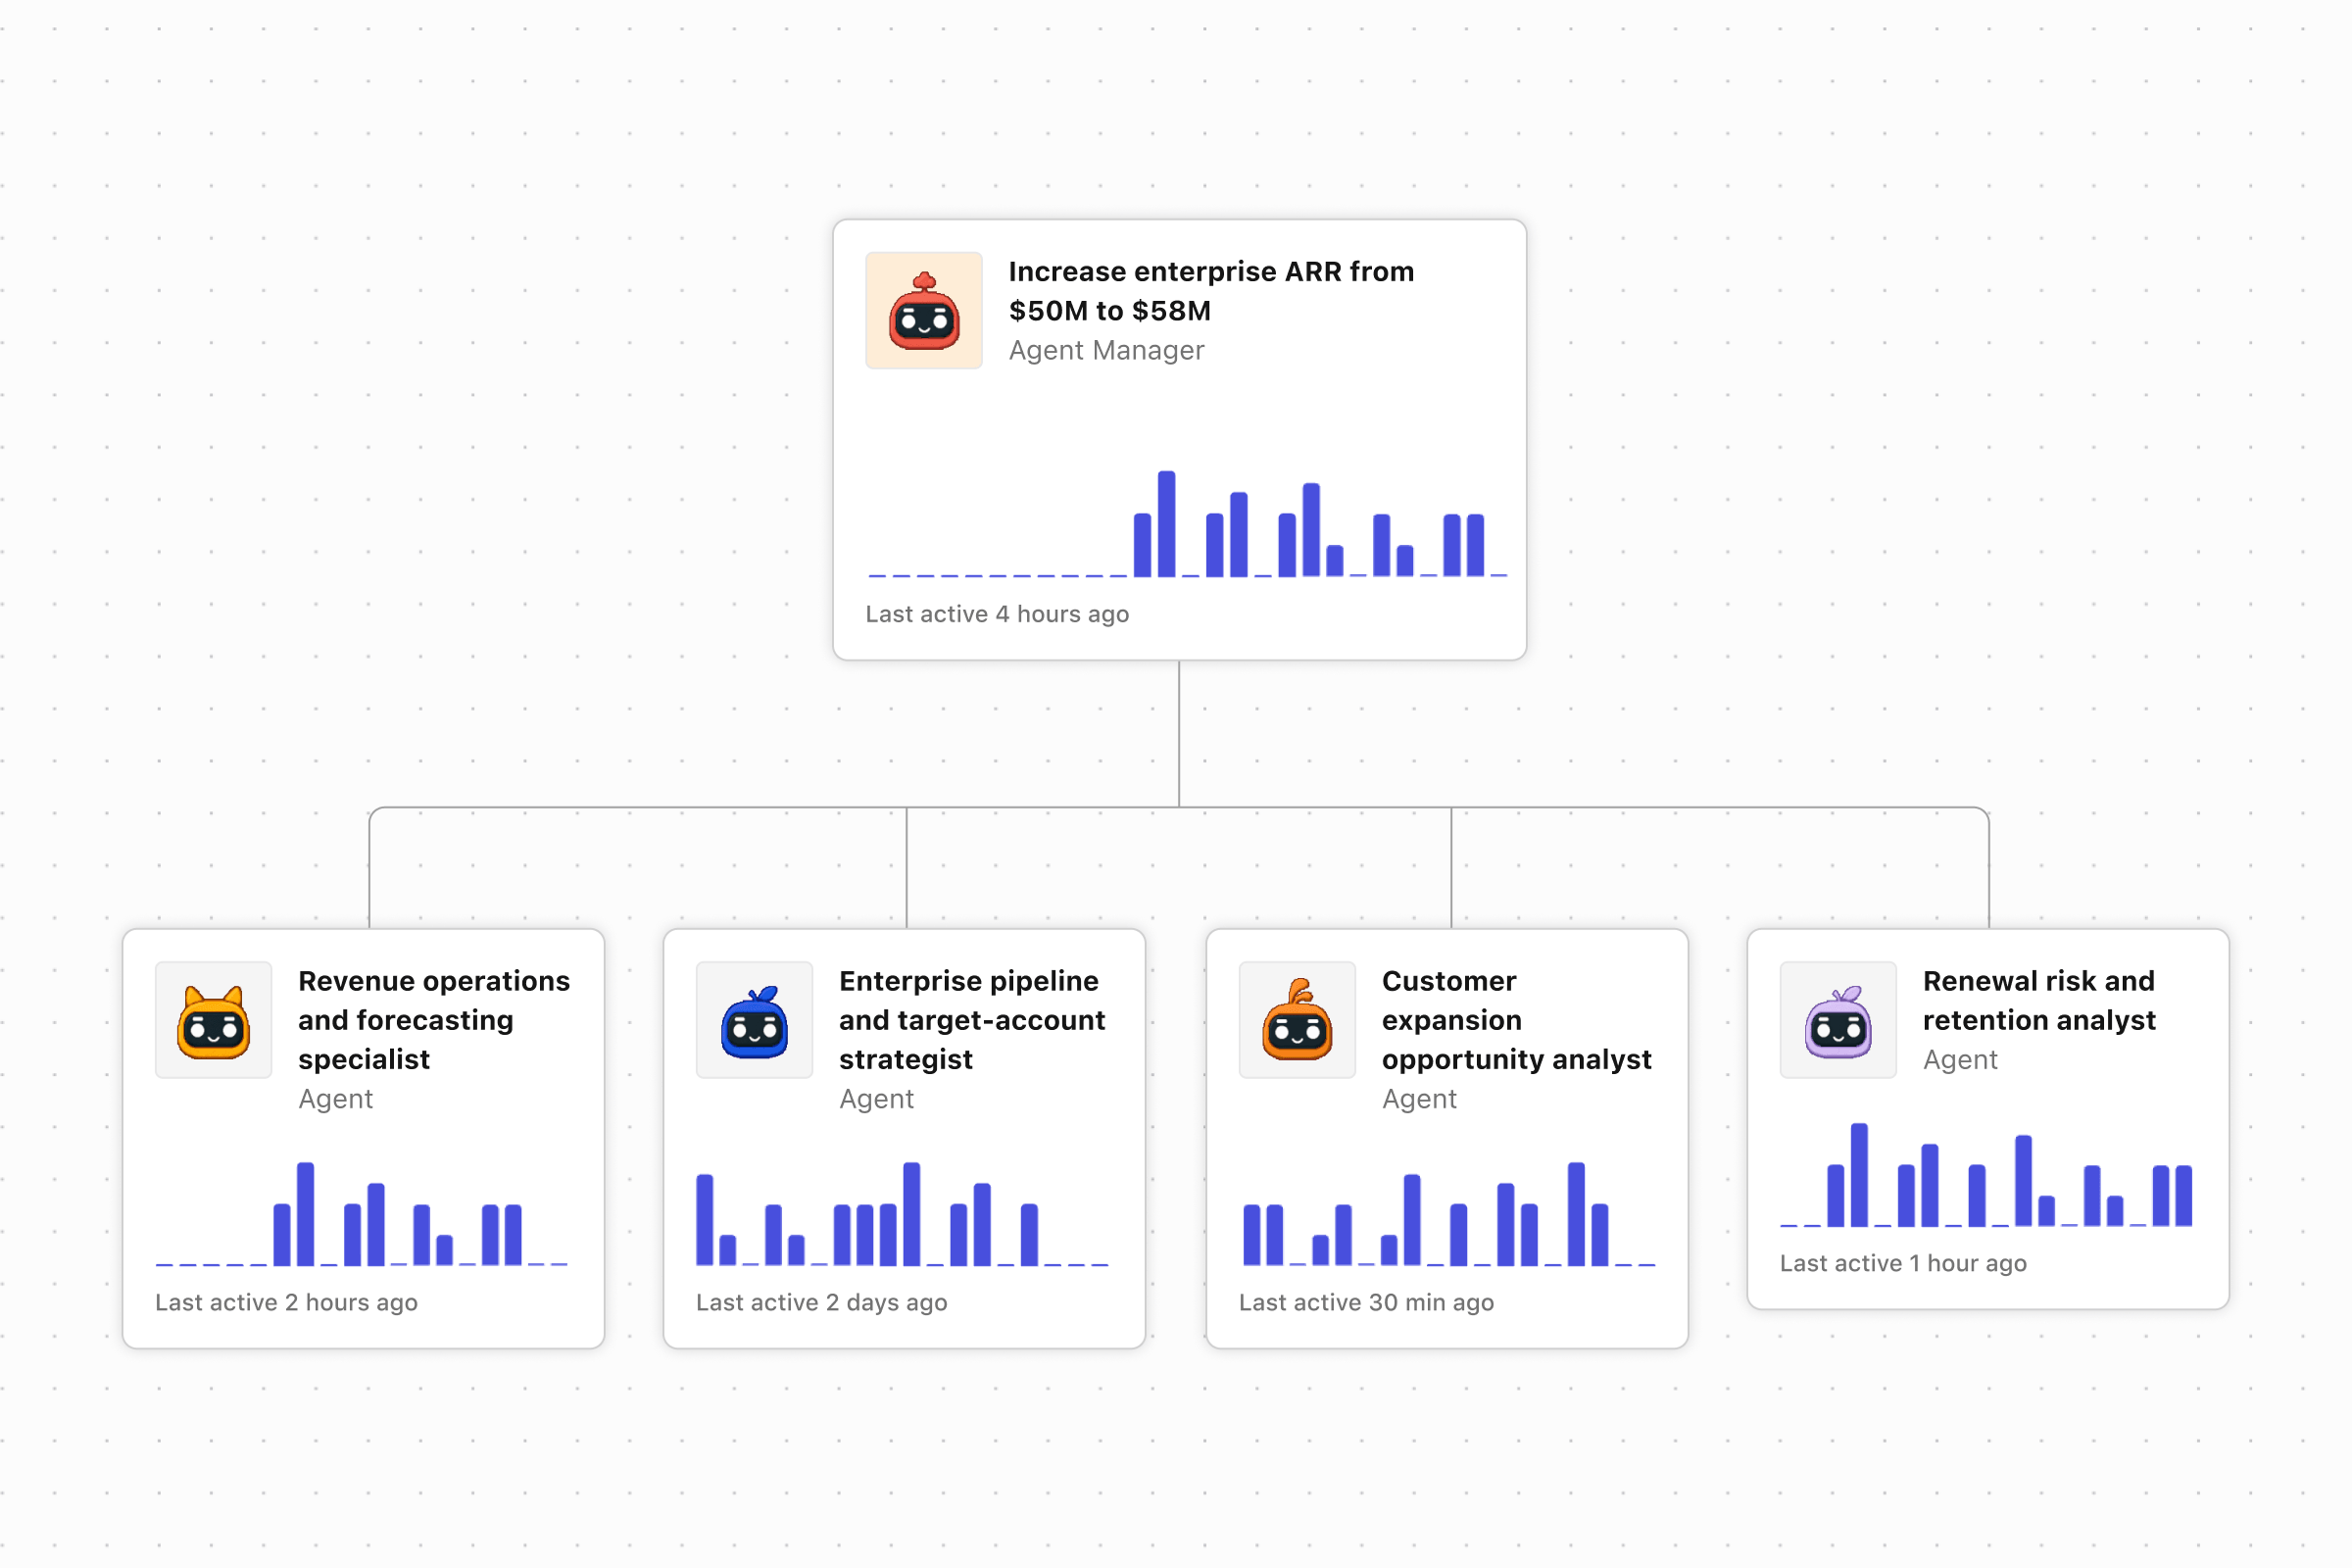
Das bedeutet auch, dass KI-Agenten keine separate Initiative außerhalb dessen sind, wie das Unternehmen bereits läuft. Wenn dein Team Ziele bereits über einen StratOps-Rhythmus verfolgt, berichtet ein Agent Manager in denselben wöchentlichen Check-in-Rhythmus wie alle anderen, statt ein paralleles Reporting-System hinzuzufügen, das niemand Zeit hat zu prüfen.
Der nächste Schritt
Enterprise-KI-Agenten müssen nicht schlauer werden, um die Mauer zwischen Pilot und Produktion zu überwinden. Sie brauchen einen Owner, einen Berichtsrhythmus und eine Stelle, an der sie an die Ziele andocken, die dein Unternehmen bereits verfolgt. Das ist das gesamte Design hinter Tabilitys Agent Manager.
Melde dich an und sieh, wie es mit einem echten Ziel funktioniert, oder buch 30 Minuten mit uns, und wir gehen durch, wie ein Agent Manager für dein Team aussehen könnte. Ob mit Tability oder nicht, es lohnt sich, eine echte Antwort auf die Verantwortungsfrage zu haben, bevor dein nächster Agenten-Pilot startet.