Pregunta a cinco personas que estén construyendo con agentes ahora mismo qué significa la orquestación de agentes y obtendrás cinco respuestas distintas. Para una persona es LangGraph o CrewAI enrutando una tarea entre modelos. Para otra es un agente 'manager' que reparte trabajo entre especialistas. Para alguien más es una capa de gobernanza que apenas involucra agentes.
Un hilo de r/AI_Agents le puso nombre a la frustración:
¿Soy el único al que le molesta que 'orquestación' ahora signifique literalmente todo en la IA?
Su argumento: los proveedores usan la palabra para al menos tres capas distintas, coordinación de agentes, enrutamiento de flujos de trabajo y gobernanza, y tras 27 comentarios, nadie se había puesto de acuerdo sobre dónde termina una y empieza la siguiente.
Sin embargo, la confusión no es realmente una cuestión de semántica. Se le pide a 'orquestación' que describa dos trabajos genuinamente distintos, y la mayor parte de lo que se comercializa bajo ese nombre solo hace uno de ellos.
El trabajo uno es el enrutamiento. El trabajo dos es la rendición de cuentas.
El trabajo uno es técnico: dada una tarea, decidir qué modelo o herramienta se encarga de cada paso, transmitir el contexto, reintentar si algo falla. Esto es lo que realmente hacen la mayoría de los frameworks de orquestación, LangGraph, CrewAI, pipelines a medida, y es un problema razonablemente resuelto.
El trabajo dos es un problema de gestión, no de enrutamiento: quién es responsable de que un objetivo avance de verdad, qué agentes existen y por qué, y qué ocurre cuando uno de ellos deja de justificar su lugar. Casi nada de lo que se comercializa como 'orquestación' hace este trabajo. Un hilo popular en el mismo subreddit señaló esta brecha sin rodeos, argumentando que muchas arquitecturas multiagente añaden roles de manager y de reviewer que nunca se contrastan con nada real, un organigrama sin ningún rastro de responsabilidad detrás. Pienses lo que pienses de esa crítica, apunta al mismo hueco: un enrutador no es una capa de gestión, y llamarlo así no lo convierte en una.
Incluso los planteamientos más rigurosos del sector se quedan cortos. El modelo inner-loop/outer-loop de un proveedor de automatización de cargas de trabajo empresariales divide el trabajo de los agentes en una capa de ejecución (razonamiento, llamadas a herramientas) y una capa de gobernanza (estado, reintentos, aprobaciones), y hasta ahí llega: una capa de ejecución y una capa de gobernanza de procesos, nunca una que se pregunte quién es responsable del objetivo.
El verdadero cuello de botella no es el enrutamiento, es la supervisión
Esa brecha se manifiesta como un problema muy concreto y práctico en cuanto los equipos superan un solo agente. Un hilo de r/AI_Agents dedicado exactamente a esto descubrió que hacer funcionar un solo agente de codificación es manejable, pero que supervisar varios ejecutándose a la vez se convierte rápidamente en el verdadero cuello de botella, no el enrutamiento entre ellos, sino la pura carga de detectar qué está haciendo mal cada uno. Una persona lo expresó de forma más directa mientras buscaba herramientas de 'orquestación / jefe de gabinete' para mantener organizados a sus agentes y proyectos: lo que realmente buscaba no era un enrutador, sino algo que sostuviera el trabajo de coordinación que una persona se veía obligada a hacer a mano.
Ese es el problema que le corresponde resolver al trabajo dos. Una capa que solo enruta mensajes entre modelos no lo toca. Lo que de verdad ayuda es algo que le quita la carga de supervisión a una persona, no solo la lógica de traspaso a un modelo.
Qué significa la orquestación de agentes en Tability
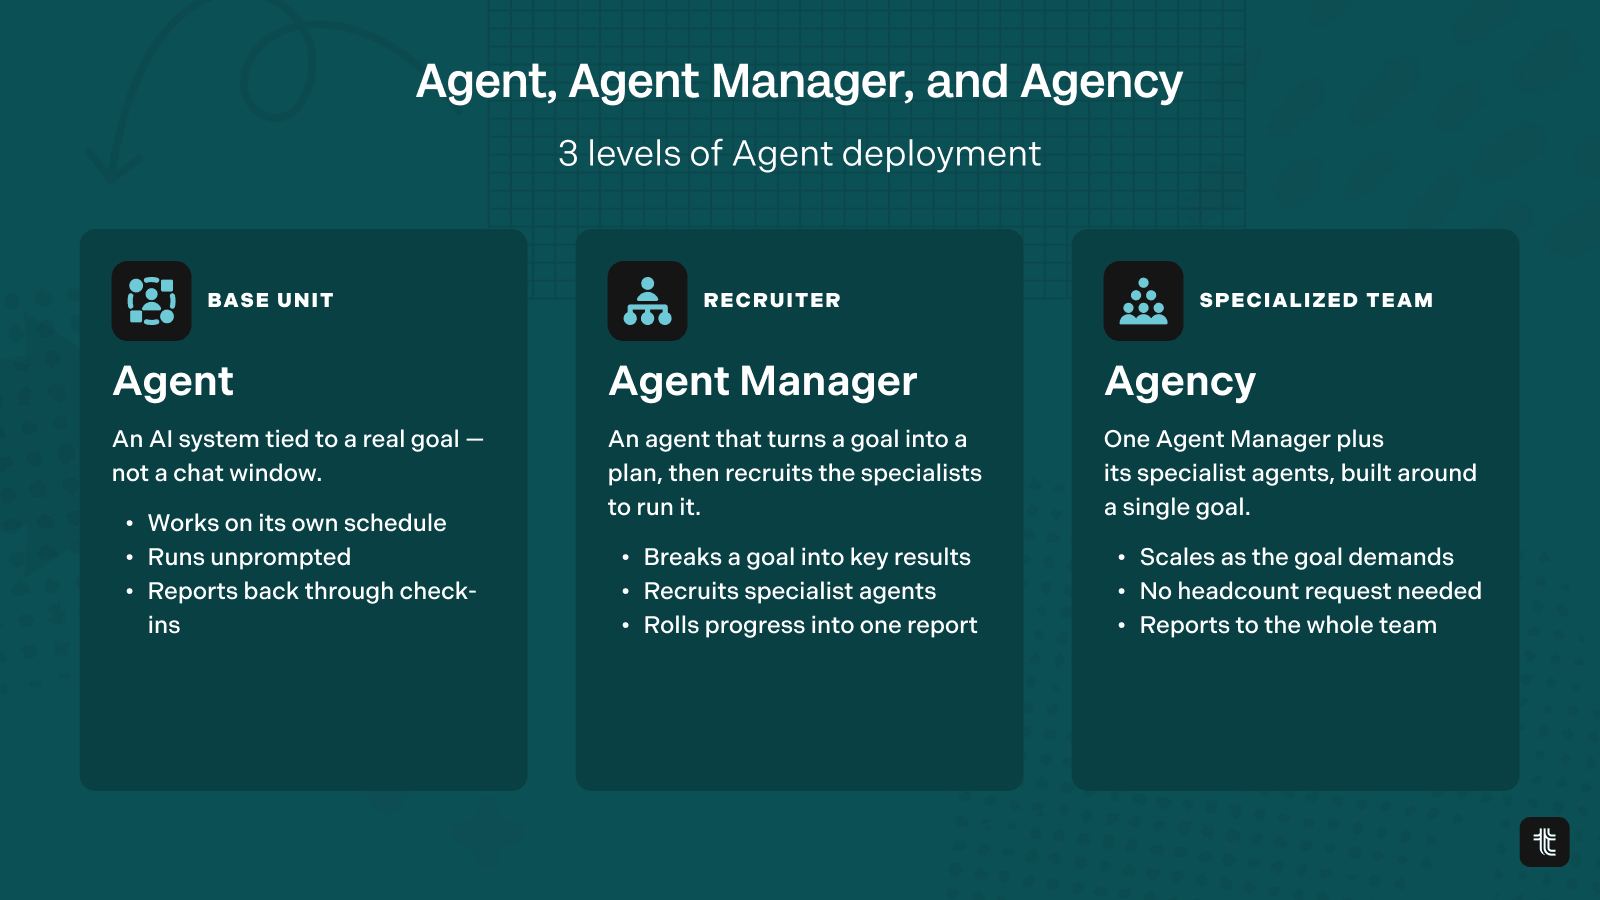
Esto es lo que el Agent Manager de Tability está diseñado para hacer. No hay una plantilla fija de agentes esperando a que se les asigne trabajo. Empiezas con un objetivo, una métrica, un valor base, una fecha límite, la misma forma que un key result dentro de un framework de OKR, no una tarea pendiente. Un Agent Manager asume la propiedad de ese objetivo, lo descompone en un plan, y solo entonces determina qué especialistas necesita realmente el plan. Tability llama a la unidad resultante una Agency: un manager más el equipo que su propio plan haya pedido, actualmente limitado a seis en total mientras el sistema aprende dónde empieza a fallar la coordinación con un equipo más grande.
'Tability actúa como la capa de contexto de negocio y orquestación', como lo expresó el equipo al describir su propio sistema de equipos de agentes que se autocontratan, y esa es la distinción que importa aquí. No se trata de decidir qué modelo maneja qué paso. Es la capa que sostiene el objetivo, el plan, y el registro de si algo realmente avanzó, que es exactamente el trabajo para el que los frameworks de enrutamiento nunca se diseñaron.
También es la misma disciplina operativa que StratOps ya aplica a los equipos humanos, un responsable, una cadencia, un registro visible del progreso frente a un número real, solo que ampliada para cubrir a agentes reclutados para un objetivo en lugar de contratados para un rol.
La gente ya está construyendo el trabajo dos a mano
Esto no es una necesidad hipotética. Un hilo de r/AI_Agents que preguntaba si alguien había probado un patrón de 'agente manager que asigna trabajo a agentes especialistas' recibió decenas de respuestas de personas que ya hacían exactamente eso, con resultados mixtos. Un profesional describió cómo le daba una especificación a un agente, dejaba que dividiera el trabajo en módulos, y luego generaba y ejecutaba agentes independientes de codificación, pruebas y revisión para cada uno, reduciendo un proyecto que habría llevado seis semanas de 40 horas a unas diez horas de trabajo supervisado. Otros advirtieron que el mismo patrón puede producir con la misma facilidad una 'arquitectura absurda' llena de agentes haciendo lo que un solo agente bien equipado, o un simple script determinista, podría haber hecho más rápido y más barato.
Ambas cosas son ciertas, y ahí está la clave. El patrón manager-más-especialistas es real y funciona, pero que una instancia concreta valga el sobrecoste depende por completo de si está anclado en un objetivo real o si se montó porque parecía el tipo de configuración que un sistema 'de verdad' debería tener. Ese es el juicio que Agent Manager hace de forma estructural, derivando el equipo a partir del plan, en lugar de dejarlo en manos de quien esté ensamblando hilos a mano esa semana.
| Dimensión | Configuración multiagente improvisada | Tability Agent Manager |
|---|---|---|
| Cómo se decide el equipo | Ensamblado a mano, hilo a hilo, antes de que empiece el trabajo | Derivado del plan una vez fijado el objetivo |
| Quién responde por el objetivo | Normalmente, nadie en concreto | El Agent Manager, para ese objetivo |
| Qué pasa si un agente no aporta nada | Sigue funcionando, a menos que alguien lo note | No vuelve a ser reclutado en el siguiente ciclo |
| Dónde recae la carga de supervisión | En una persona, y crece con cada agente añadido | La sostiene la propia capa, con check-ins e informes |
| Cómo sabrías que está funcionando | No lo sabrías, sin leer los logs | La propia métrica del objetivo |
El tamaño del equipo no es la variable interesante. Quién responde por él, sí.
Cómo se ve esto en la práctica
En un desarrollo reciente, un único objetivo, aumentar el valor del tráfico de 15.000 $ a 20.000 $, se le entregó a un Agent Manager. Fíjate en lo que no ocurrió: nadie decidió de antemano que el equipo necesitaba una persona de SEO, un especialista en reparaciones y un especialista en PR. El manager descompuso primero el objetivo en un plan, y fue el plan el que produjo esos tres roles, en esa combinación, específicamente para ese objetivo. Un objetivo distinto habría reclutado un equipo distinto. Pasar de la configuración a un equipo operativo tomó unos dos minutos, sin contar el tiempo de reflexión entre medias, y Tability publicó todo el proceso como un speedrun de la configuración.
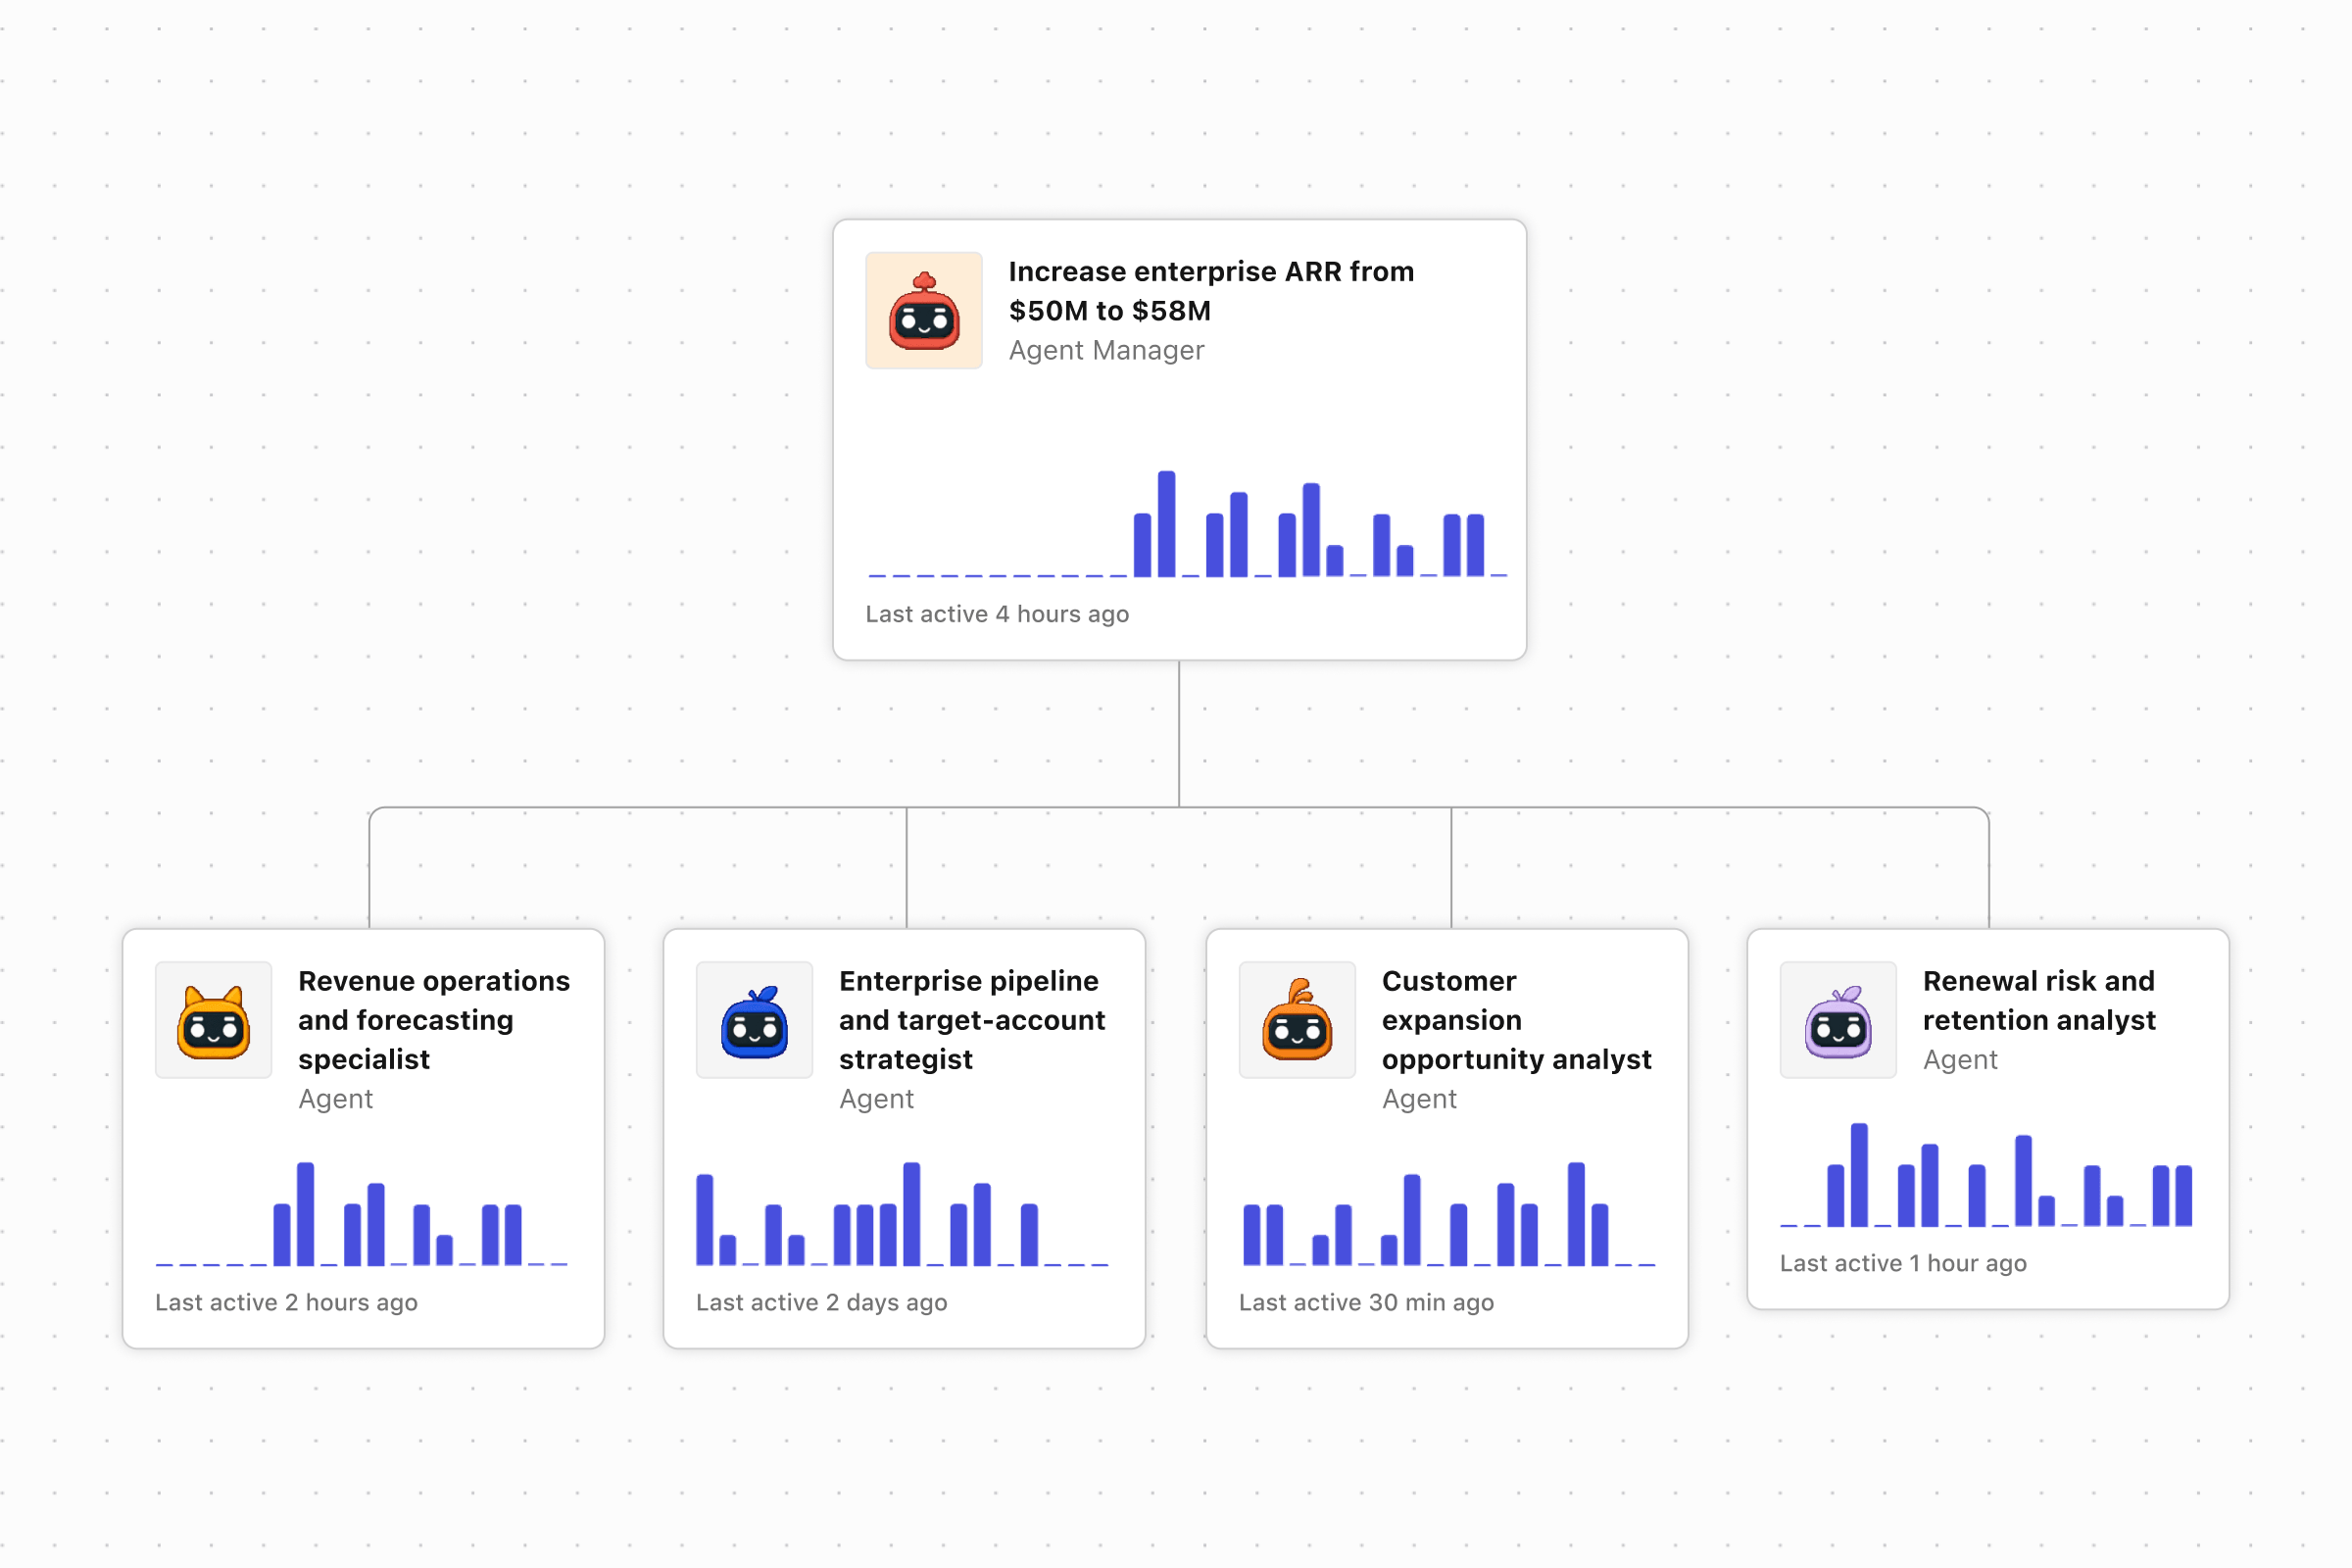
Si te alejas un poco, las cifras se vuelven más interesantes, y más moderadas de lo que cabría esperar de un sistema construido para escalar agentes. Una versión anterior del sistema de agentes autocontratados de Tability creció hasta 20 agentes a partir de solo cuatro managers, con un plan declarado de seguir escalando más allá de 100. Pero el tamaño del equipo por Agency se sitúa actualmente en seis (un manager más cinco especialistas), un límite deliberado mientras el equipo aprende dónde empieza a fallar la coordinación con una plantilla más grande. Incluso dentro de un sistema construido a propósito para esto, el fan-out ilimitado no es el objetivo. Sí lo es un equipo que solo crece cuando el plan realmente pide más manos.
El cuello de botella, según el propio relato del equipo, nunca fue conseguir que los agentes hicieran el trabajo. Fue mantener el ritmo de lo que volvía: informes, propuestas, preguntas, actualizaciones. Es la misma carga de supervisión que describía el hilo multiagente mencionado antes, y es, de una manera curiosa, una buena señal: significa que los agentes estaban haciendo suficiente trabajo real como para generar cosas reales que revisar, no solo produciendo actualizaciones de estado entre ellos.
Montar el equipo antes que el objetivo es el error habitual
El instinto, cuando los agentes empiezan a trabajar, es esbozar primero el equipo. Un orquestador aquí, un reviewer allá, un especialista para cada función que se te ocurra, decididos de antemano, antes de que exista una sola tarea real que justifique a ninguno de ellos.
La solución no es una biblioteca de prompts mejor para esos roles. Es no diseñar el equipo en absoluto, de antemano. Asignas el objetivo, dejas que el plan revele exactamente lo que necesita, y tratas la existencia continuada de cada agente como algo que hay que volver a ganarse en cada ciclo, no algo concedido una vez en la configuración inicial.
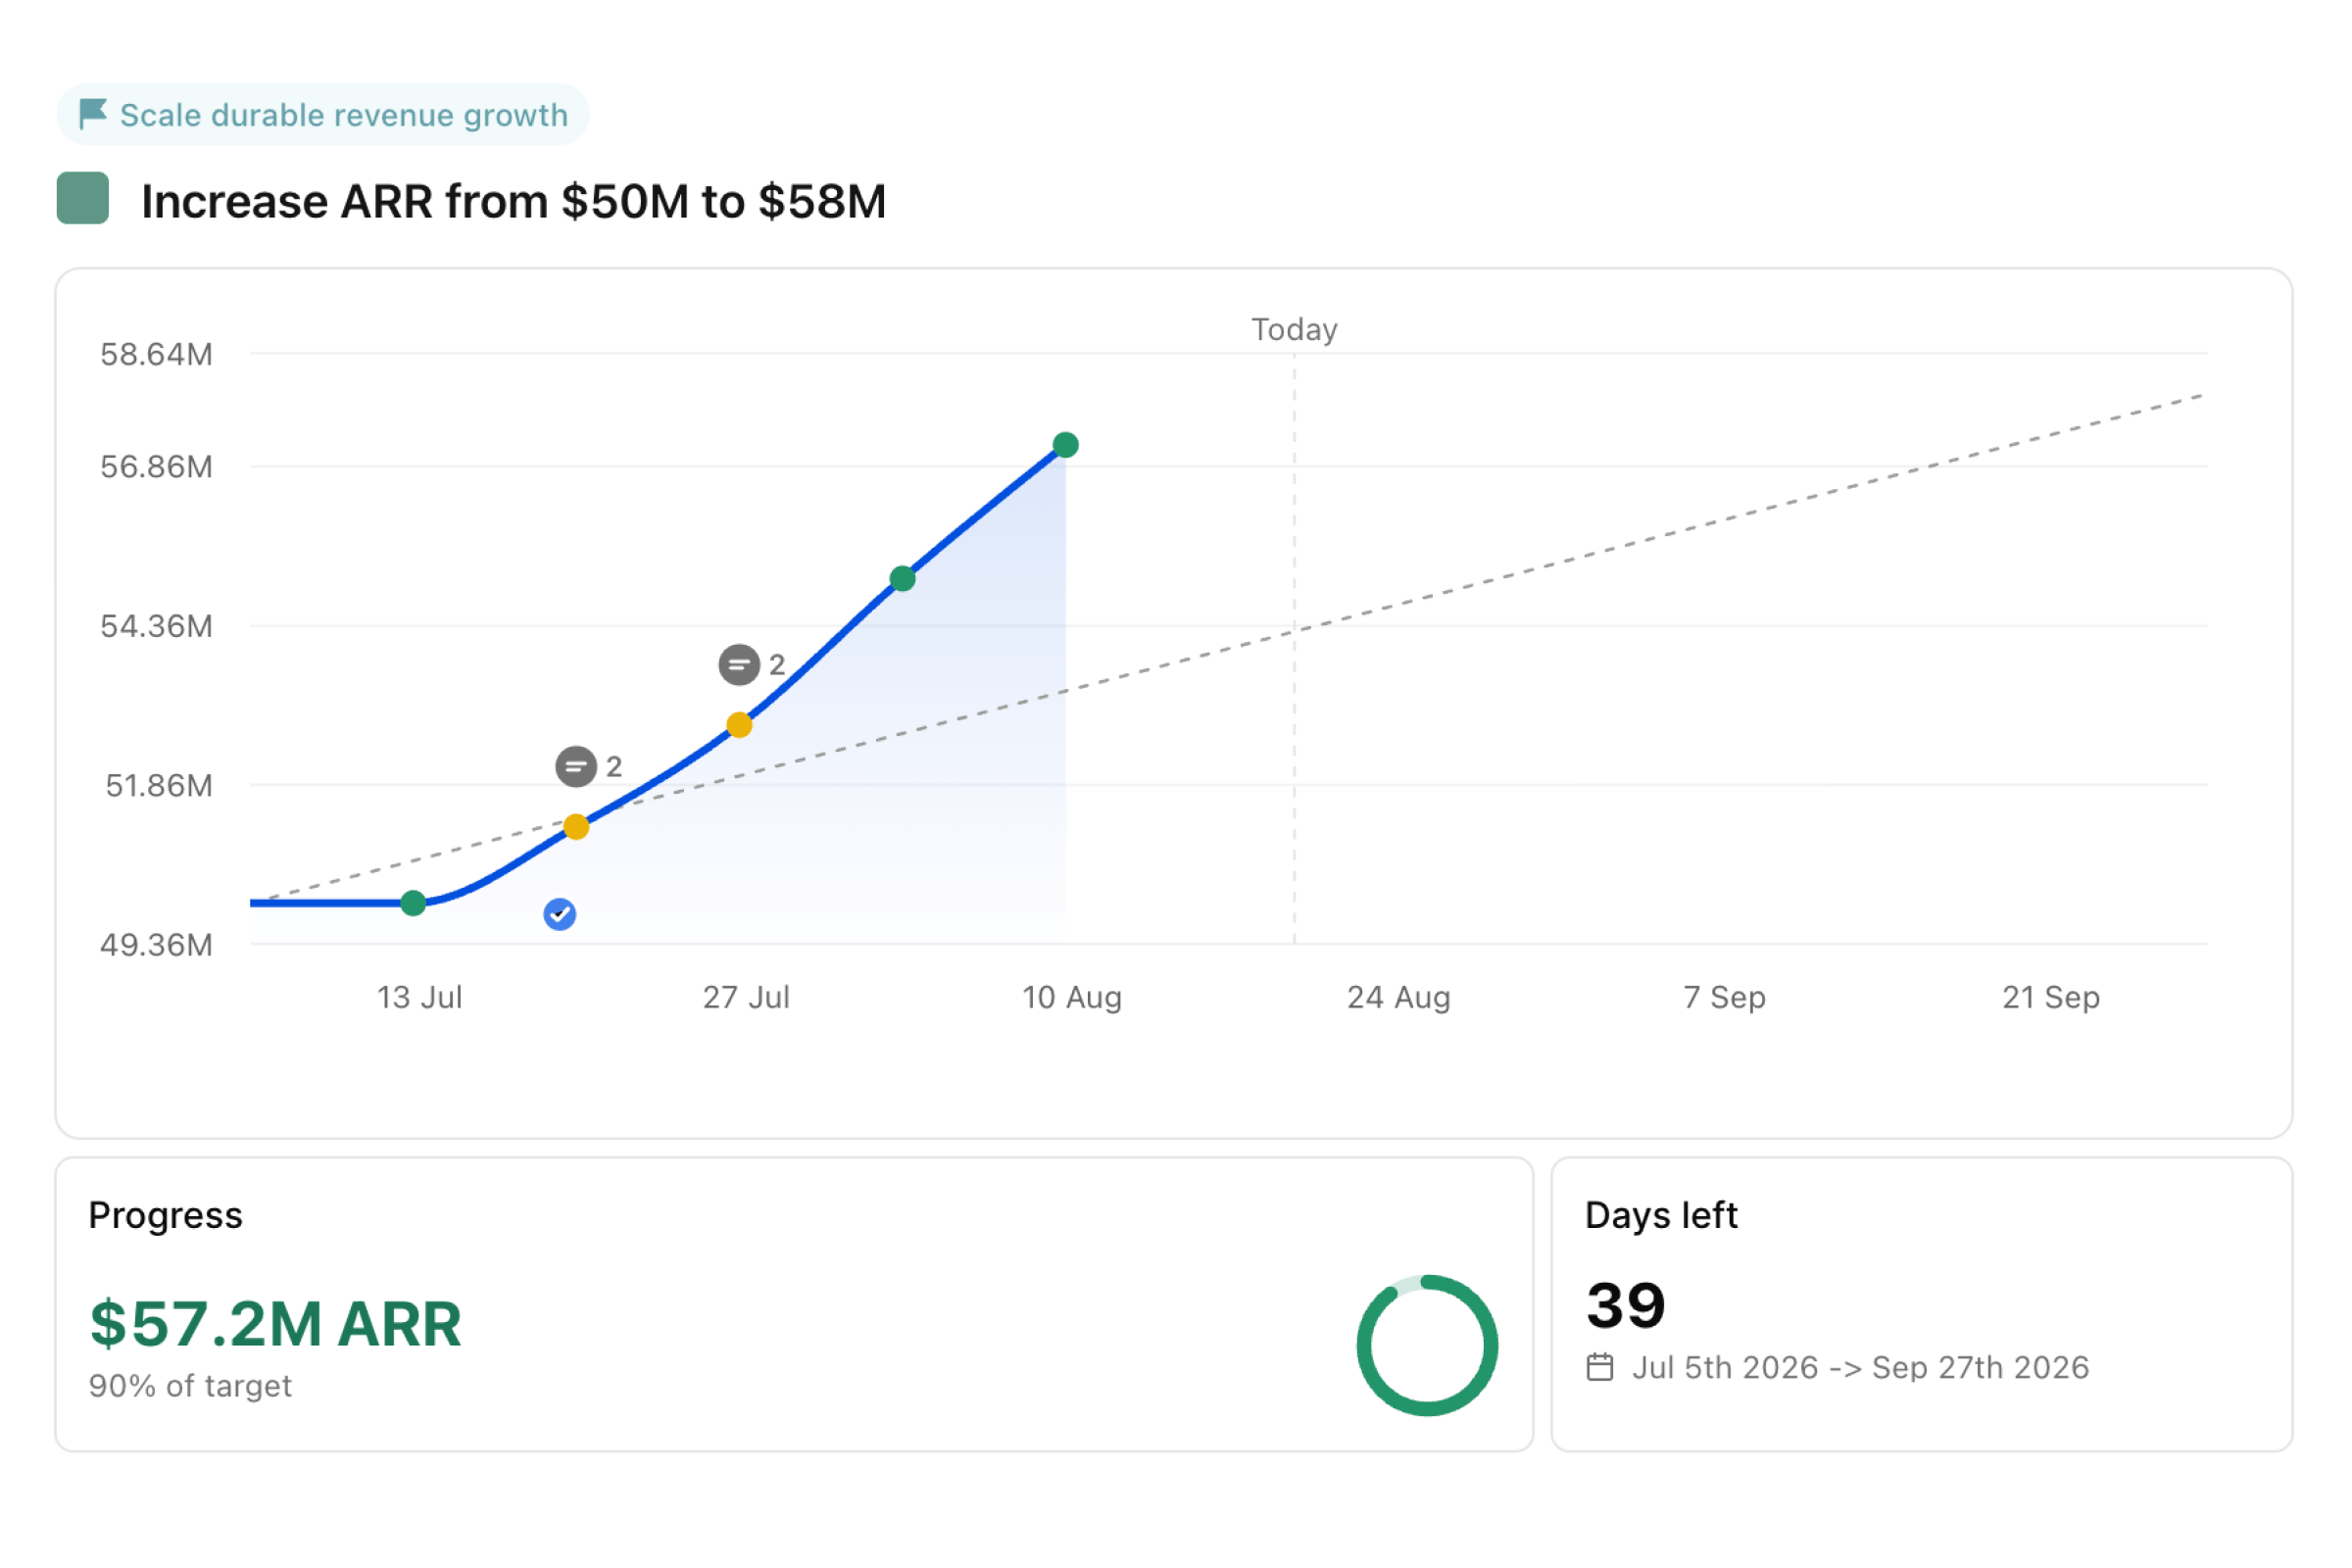
Aquí es también donde la mayoría de las configuraciones de orquestación caseras fallan en silencio: no en el enrutamiento técnico, sino en la rendición de cuentas. Ningún objetivo al que un agente determinado esté realmente vinculado, ninguna cadencia fija para comprobar si movió algo, ningún lugar único donde un compañero de equipo pueda mirar para ver qué es real frente a lo que simplemente está en marcha. Acabas con mucha producción y un trabajo de supervisión creciente que nadie pidió.
Por dónde empezar
Antes de añadir el siguiente agente a tu configuración, tres preguntas son más útiles que cualquier comparación de frameworks:
- ¿Hay un único lugar donde podrías comprobar si el trabajo de este agente movió el objetivo, sin leer un registro de chat?
- Si lo eliminaras, ¿tendría una persona que asumir la carga de supervisión, o realmente no cambiaría nada?
- ¿Se reclutó porque el plan lo pedía, o porque parecía el tipo de rol que se supone que debe tener un equipo como este?
Si ya estás ejecutando agentes a través de Claude o Codex, nada de esa infraestructura desaparece. Tability no reemplaza tus modelos ni tus herramientas. Se sitúa por encima de ellos como la capa que sostiene el objetivo, el plan, y el registro de si algo realmente ocurrió, para que puedas responder a esas tres preguntas sin rebuscar en un registro de chat.
Prueba Tability gratis, o reserva 30 minutos con nosotros y revisaremos tu configuración real, agente por agente, y te ayudaremos a averiguar quién es realmente responsable de qué. Con o sin Tability, vale la pena conocer la respuesta.